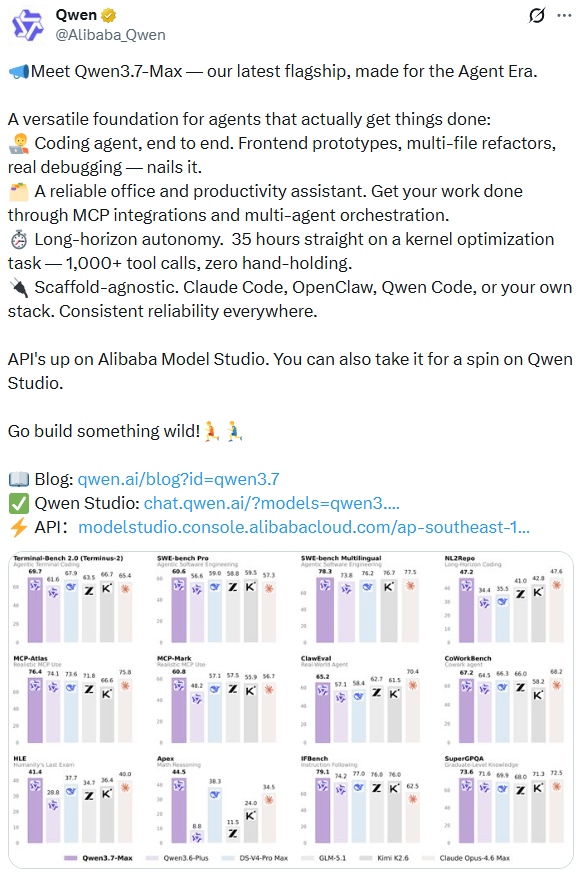
在人工智能的竞技场上,一项里程碑式的记录刚刚被中国大模型打破。长期以来,全球顶级AI编程能力的王座一直被硅谷巨头们牢牢把持。就在昨天,Code Arena最新榜单震撼出炉,不仅重新洗牌了现有的AI大模型编程能力排名,更向全世界宣告了一个不可忽视的事实:在最硬核的编程代码领域,中国模型不仅站上了牌桌,而且直接杀入了决赛圈。Qwen3.7-Max以高达1541分的傲人成绩,强势冲进全球前四,一举超越了曾经的神话GPT-5.5以及谷歌的Gemini 3.5 Flash等一众顶尖模型。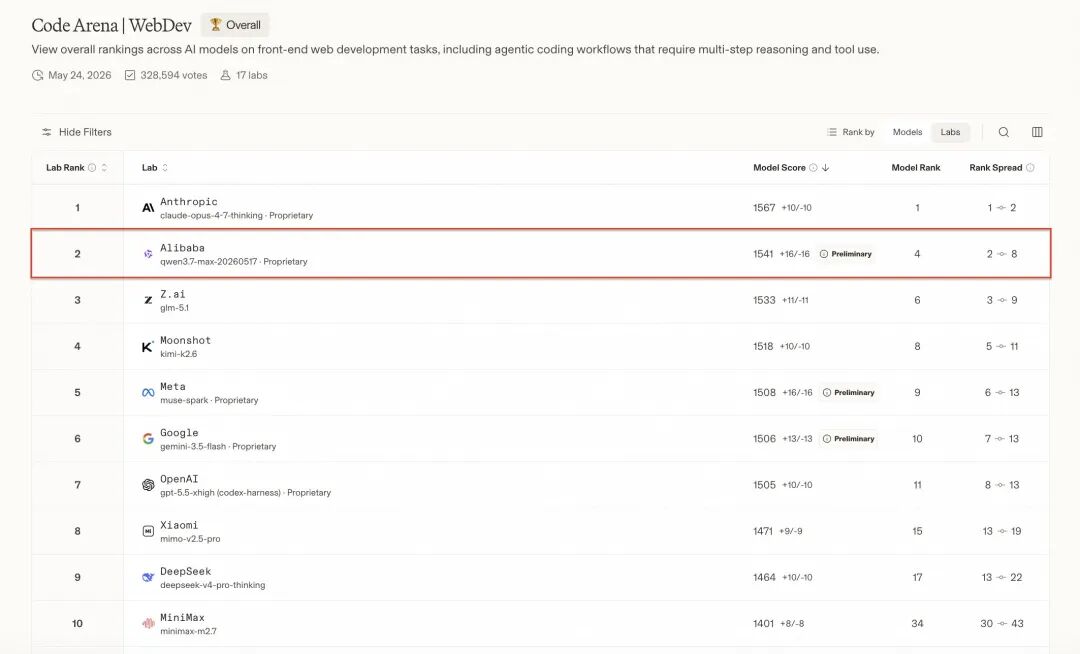 在全球编程模型的巅峰对决中,阿里成为了唯一杀进前五的中国厂商,甚至也是榜单前列唯一非Claude系的模型。
不仅跑分高,实战更强悍
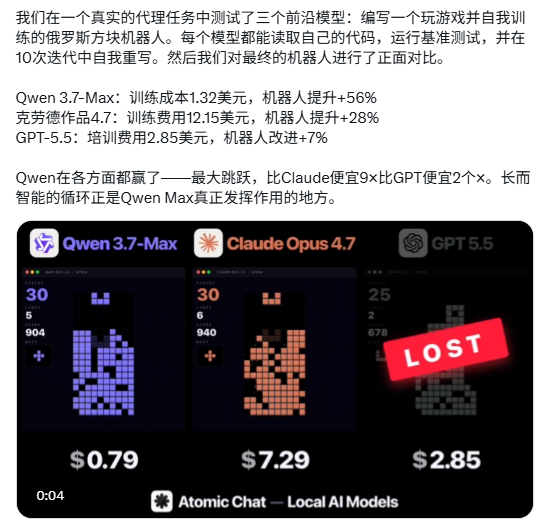
跑分仅仅是入场券,真正让开发者们震撼的,是Qwen3.7-Max在真实复杂项目中的降维打击。海外知名评测机构Atomic Chat进行了一场硬碰硬的盲测对决,任务要求是让AI从零开始写一个能够自我训练的俄罗斯方块AI程序。这场备受瞩目的Qwen3.7-Max和GPT-5.5对比测试结果令人咋舌:Qwen3.7-Max不仅成功交付了高质量的完整代码,其性能表现相较于竞品提升了惊人的56%。图片来源:atomic.chat
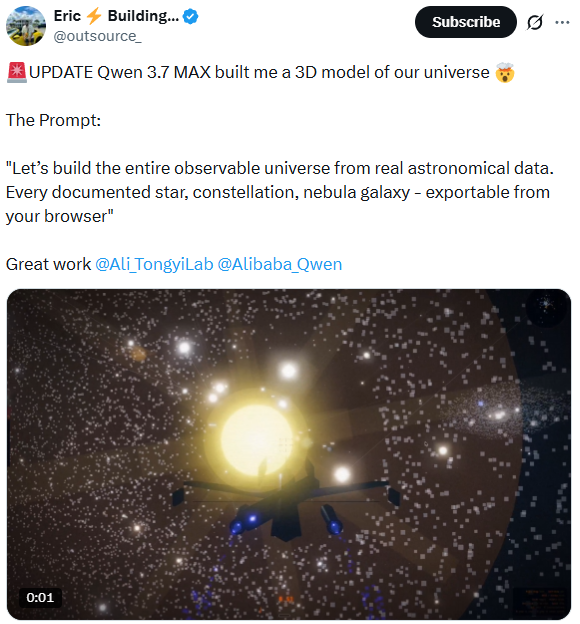
更让开发者狂喜的是成本,完成整个复杂任务,Qwen3.7-Max仅仅消耗了1.32美元的Token费用,在性价比和绝对性能上实现了对Opus 4.7和GPT-5.5的双杀。除了逻辑严密的算法代码,Qwen3.7-Max在空间想象和视觉代码生成上同样表现出了统治力。另一位海外资深开发者尝试让其构建一个包含复杂物理引擎的宇宙3D模型。图片来源:Eric Building...
在探讨如何使用AI构建3D模型这个前沿课题时,Qwen3.7-Max展现出了不可思议的输出速度与极高的渲染质量,最终呈现的宇宙模型和3D像素风微缩宝塔细节极其丰富,效果足以用震撼二字来形容。重新定义基座:35小时的不间断战役
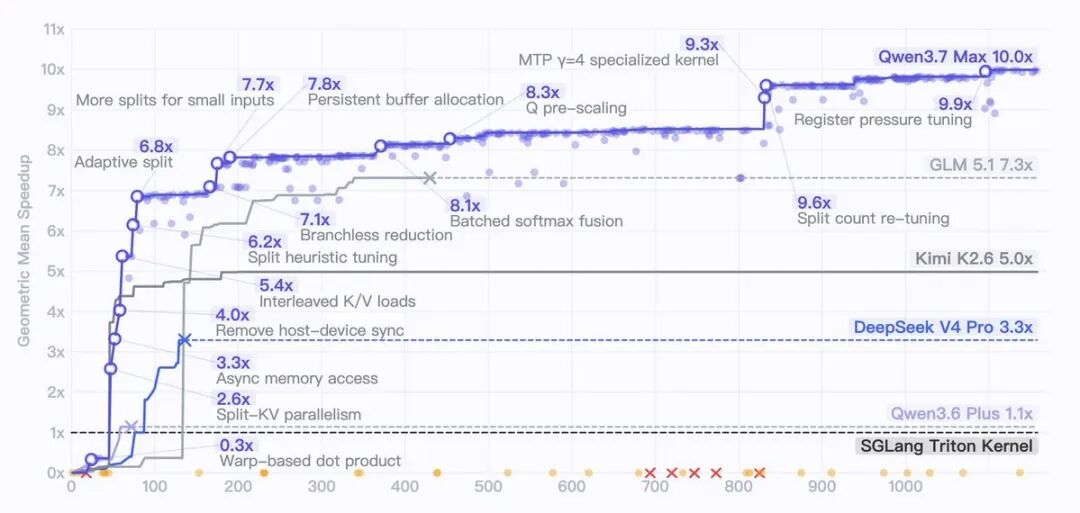
Qwen3.7-Max之所以能在最卷的编程擂台上大杀四方,答案隐藏在它的底层产品定位里。阿里在发布它时,赋予了一个极具野心的标签:Agent基座模型。当我们讨论AI Agent基座模型有哪些时,过去往往只能列举国外的几个闭源巨头。但Qwen3.7-Max生来就是为长时间、高复杂度、自主执行任务而设计的。在一场极具挑战性的内测中,Qwen3.7-Max展现了堪称恐怖的持久战能力。面对一项底层Kernel级优化任务,Qwen3.7-Max连续自主运行了35个小时,期间自主进行了1158次工具调用,不断试错、修改、编译、回溯。最终它生成的代码,相较于业界标准的Triton参考实现,达到了惊人的10倍几何平均加速。在针对超长上下文大模型评测的历史数据中,绝大多数模型在处理此类长程任务时都会面临灾难性的崩溃:要么上下文越积越乱,前半段定下的核心目标在几百轮对话后忘得干干净净;要么陷入死循环,像无头苍蝇一样反复尝试同一个已经报错的代码方案。但Qwen3.7-Max做到了全程零上下文退化、零指令漂移、零死循环。在推演进行到第30个小时之后,它依然保持着极其敏锐的代码嗅觉,持续挖掘出新的优化空间。把做对一件事变成持续35小时做对极其复杂的事,这才是它的核心护城河。环境扩展与动态生存博弈
Qwen3.7-Max实现了如此夸张的跃升,背后的核心技术密码是什么?从技术专家的拆解来看,主要归功于两大训练机制的革命性升级。这些技术革新也为整个行业提供了提升AI代码生成质量的方法。环境扩展技术:
在传统的编程训练中,模型往往容易对特定的评测框架产生过拟合。
而Qwen3.7-Max在训练时,每一个任务都会被冷酷地拆分为三个独立维度:任务本身、执行框架、验证方式,这三者被系统进行海量自由组合。
打个比方,这就像一个实习生被疯狂轮岗到了公司所有的项目组。同样的编程题,有时候要求在Claude Code的框架里做,有时候在OpenClaw里做,有时候又换一种极其严苛的验证方式。
这种地狱模式逼迫模型学会的是解决问题的底层通用策略,而不是在自家框架里取巧的捷径。
正因如此,Qwen3.7-Max在各大外部AI自动化编程工具推荐榜单和不同框架实测中,表现出奇的稳定,彻底告别了内战内行,外战外行的窘境。
长程自主执行训练:
研发团队引入了前沿的动态累积生存博弈框架。模型必须在持续变化的模拟环境中,做出超过一千步的连续决策。在这个过程中,它需要自己建立假设、根据环境反馈动态调整策略。
在著名的YC-Bench测试中,这一能力的威力被展现得淋漓尽致。Qwen3.7-Max最终实现了208万美元的模拟营收,直接将上一代模型的成绩翻倍。
更关键的是,它展现出了类似人类的高级策略进化能力,在中期遇到严重经营危机时,模型能够自主调整业务方向,甚至精准识别并拉黑恶意薅羊毛的客户,最终收敛到一个健康、稳定的执行循环中。
中国大模型从追赶者到定义者
Code Arena上线至今,考验的从来都不是简单的代码补全,而是多步逻辑推理、复杂工具编排以及完整的端到端项目交付能力。这全都是Agent级别的真刀真枪。Qwen3.7-Max凭借硬核的实力楔入全球第四,牢牢卡在Claude两大最强模型之间。它给出的回答非常清晰:在AI的深水区,中国模型不仅是紧跟其后的追赶者,更正在成为新标准的定义者。面对能够连续自主工作35小时的超级Agent,程序员如何应对AI时代已经不再是一个科幻议题,而是迫在眉睫的现实。从单一的代码助手到通用的Agent基座,大模型正在重塑整个软件工程的生产关系。而这一次,站在浪潮最前沿的,有中国开发者的身影。