logo
首页
产品与服务
商务合作
党建相关
博客
关于我们
phone电话咨询
服务热线16625252556
phone微信咨询
微信扫一扫即刻开始对话shangwu
email联系邮箱
联系邮箱service@sohan.cn
feedback意见反馈
header

全球首次单机降服1.6万亿巨模DeepSeek-V4,最强RL后训练框架Orbit正式开源!

2026年05月29日

随着大模型技术步入深水区,行业内形成了一个共识:从复杂的数学推理、冗长的代码逻辑,到多轮的高级工具调用,模型能力的每一次跃升,都离不开强化学习后训练的加持。
然而,当模型规模动辄飙升至万亿参数的级别时,万亿参数大模型RL后训练已经不再仅仅是一个枯燥的算法推导问题,它演变成了一座横亘在所有AI团队面前的系统级大山。
算力贵、显存爆、通信慢、效果难以对齐……这些痛点让无数开发者望而却步。但今天,这一切被彻底颠覆!
Orbit:一款支持万亿参数模型RL微调的高效框架,正式宣布开源!

官方博客:https://spherelab.ai/orbit/

更令人震撼的是,研发团队通过Orbit,在全球范围内首次将Kimi-K2.6、DeepSeek-V4等万亿级巨兽的RL后训练,硬生生压缩到了单台8×B200服务器上完成!

Adapter-first系统架构设计

Orbit究竟是如何把不可能变成可能的?核心秘密在于其独创的Adapter-first整体设计。
传统的全参数微调,Weight+Grad的显存下界远远超过了单台服务器的物理极限。
Orbit不走寻常路,它选择了将Base Model完全固定在部署时使用的低精度表示,整个训练过程只更新体积极小的Adapter。
这种设计带来了两大革命性的优势:

1. 极致的显存压缩与训推精度绝对对齐

Orbit将精度对齐的问题前置到了系统设计的最底层。训练引擎和推理引擎使用完全相同的低精度Base,并在其上加载同一个BF16高精度Adapter。


这意味着,训练和Rollout走的是同一条低精度Base + 高精度Adapter的路径。


从系统层面被一刀切断的误差,让train-rollout log-prob diff保持了惊人的稳定!


2. 告别GB级的数据搬运

每次训练更新后,系统只需要将MB级别的Adapter从训练引擎推送到推理引擎,而不需要搬运GB级别的庞大Base权重。


这不仅成百上千倍地减少了权重同步的体积,更避免了频繁重建推理引擎所带来的巨大开销,大大提升了系统效率。

三大万亿巨头实测

1. Kimi-K2.6:

在针对国内顶尖的Kimi-K2.6进行测试时,训练和Rollout精度均保持在INT4 Base + BF16 Adapter。
在约200step的RL过程中,测试平台不仅没有出现OOM,反而观察到了四个极其关键的同步上升信号:
  • Reward持续上升
  • Eval Accuracy稳步上升
  • Pass@k显著上升
  • Train-rollout log-prob diff 始终保持在极度稳定的安全区间
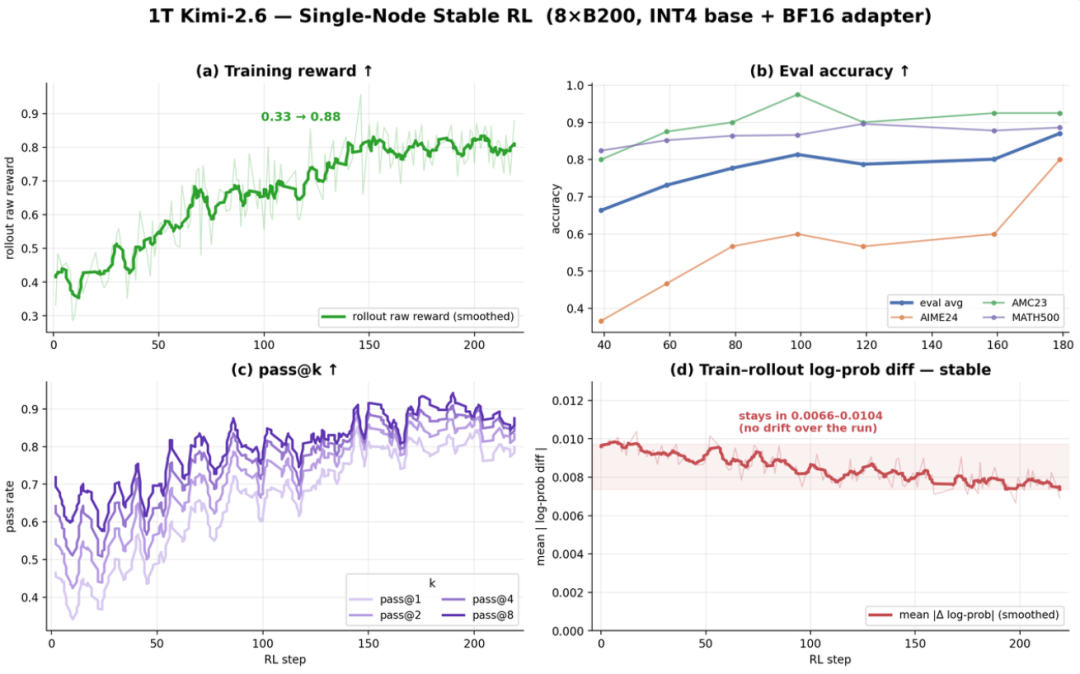
这份Kimi-K2.6模型强化学习微调的成绩单证明,Orbit在单机上不仅把1T模型跑通了,而且跑得极其漂亮、卓有成效。

2. DeepSeek-V4 Flash:

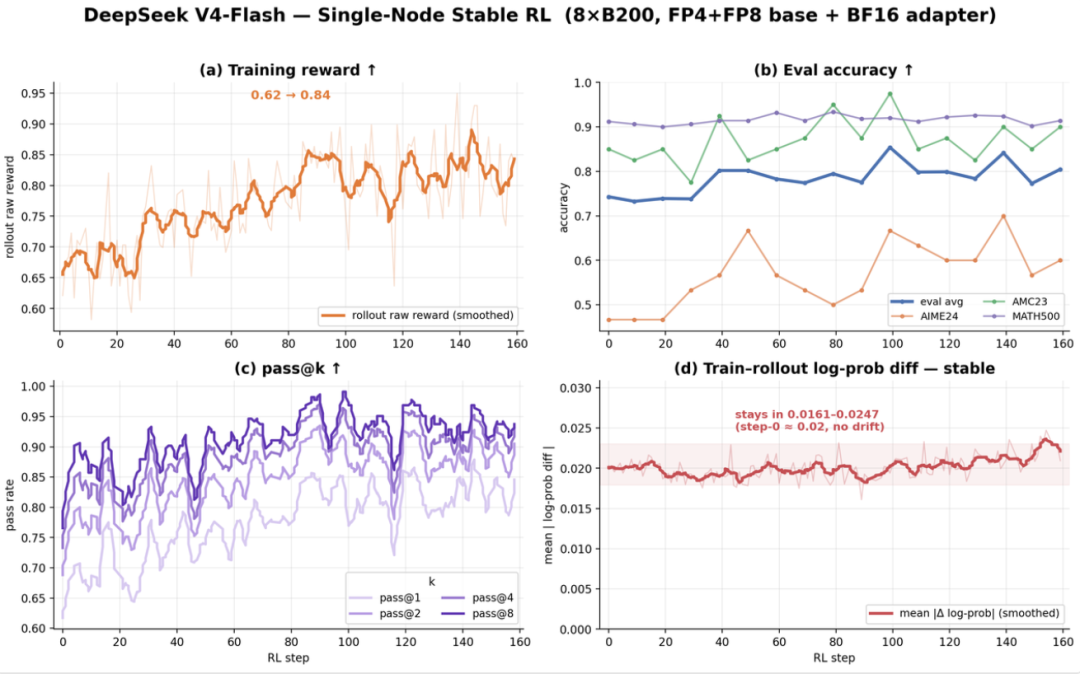
在DeepSeek-V4 Flash的测试中,Orbit将基座精度推向了更极致的FP4。结果显示,在100 step以上的RL过程中,各项指标表现与Kimi-K2.6如出一辙,Reward和通过率整体上升,模型表现极其稳定。

3. 1.6T DeepSeek V4 Pro:

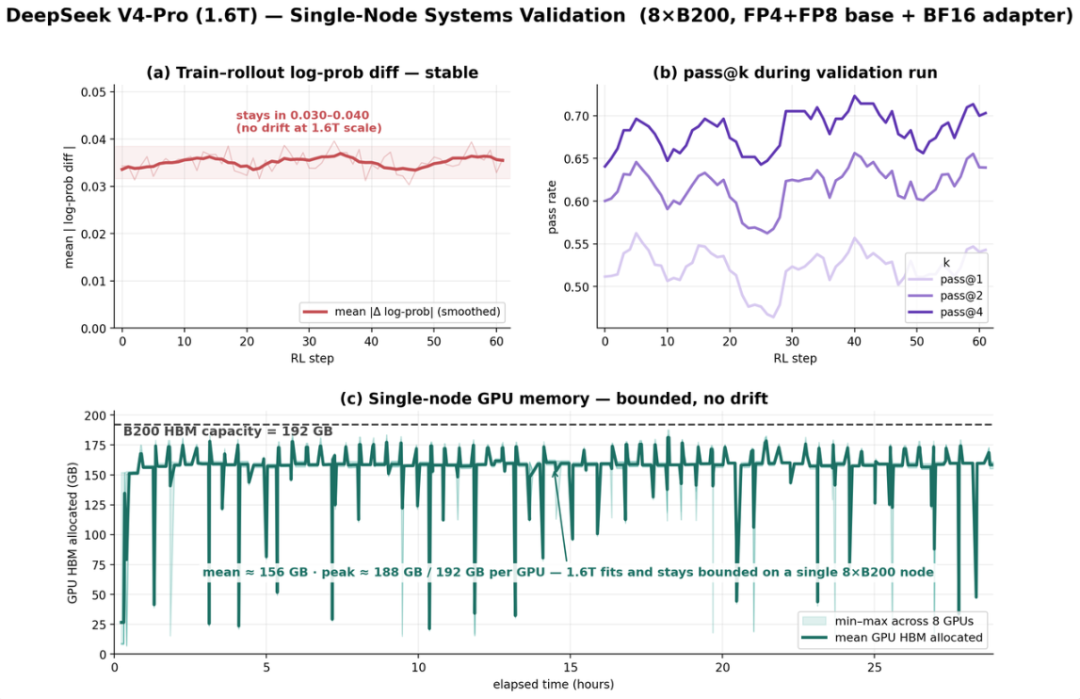
为了测试系统的极限,团队将目前参数量高达1.6万亿的DeepSeek V4 Pro拉进了单台8×B200服务器。
虽然该模型基础能力已经极其强悍,常规数据难让其涨点,但在这个实验中,Orbit成功维持了稳定的log-prob diff和可控的GPU显存。
这强有力地证明了Orbit的设计上限完全可以覆盖1.6T级别的超大MoE模型区间!

榨干每一滴GPU算力

Active-expert-chunked dequantization:

对于 MoE 模型来说,每个词元只会激活部分 experts。Orbit 动态地将 router 选中的 experts 分组成固定大小的 batch,临时反量化后执行 grouped GEMM,并在计算结束后释放高精度权重。这样既能利用 grouped matrix multiplication 的吞吐,又能将临时显存峰值限制在较小 chunk 内,避免大规模低精度 MoE 训练中的 OOM。

Adapter-native async with double-buffered rollout:

系统会为 adapter 维护版本号,并将新版本 adapter 流式写入 inactive slot;当前 active slot 继续服务 in-flight 请求,待新版本准备好后再原子切换。这样可以减少 rollout bubble。在 Qwen3-4B + OFT、8×B200、TP=2 设置下,该设计带来了 1.42 倍的单步时间优化和 44% 更高的 rollout throughput,同时 eval accuracy 保持不变。

专为DeepSeek V4定制的全栈优化:

Orbit 支持 Full-CUDA graph decoding、DeepGEMM、DeepEP V2,并使用 tilelang / Triton / CUDA 实现高效 attention backward 和 fusion kernels。根据 adapter 训练的特点,Orbit 还设计了 bypass-base-weight-grad 的高效 GEMM backward 算子,避免为冻结 base 计算不必要的梯度。

过去,提及大模型RL后训练,人们脑海中浮现的总是庞大得令人窒息的多机系统、极其繁重的权重同步、以及错综复杂的分布式调度。
而Orbit的横空出世,劈开了一条全新的道路。它通过冻结低精度基座+专注更新Adapter的策略,不仅实现了训练、Rollout和部署的三端完美对齐,更将动辄需要几百张卡的万亿模型,硬生生拉进了单节点训练的舒适区。
但Orbit的野心远不止于此。
单机能跑通万亿模型,反过来也意味着:在相同的硬件预算下,中小企业和个人开发者可以获得更宽广的训练空间。在Orbit的框架下,那些原本需要多卡才能支撑的中小模型,现在不仅单卡就能跑,甚至能支持更长的Context Response、更暴力的Batch Size、以及更高频的迭代更新!