




最近,一篇题为“CODA: Rewriting Transformer Blocks as GEMM-Epilogue Programs”的论文引发关注。
论文标题:CODA: Rewriting Transformer Blocks as GEMM-Epilogue Programs
论文地址:https://arxiv.org/abs/2605.19269
FlashAttention 作者Tri Dao在X上也力推这项工作:“通过数学重写,Transformers 的所有计算都可以看作一系列 GEMM+尾声。
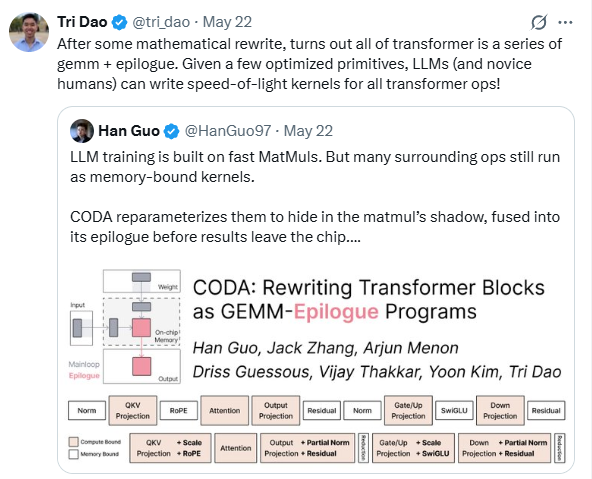
给定优化原语,LLM都能为所有 Transformer 操作编写光速内核!这意味着,LLM 自动编程加CUDA 内核开发门槛都可能被大幅降低。
训练大模型的内存搬运瓶颈
要理解CODA的意义,首先得看看大型 Transformer 训练的实际瓶颈。
以在NVIDIA H100上训练 1B 级别LLaMA-3为例,我们直觉认为时间都花在矩阵乘法和注意力计算上。
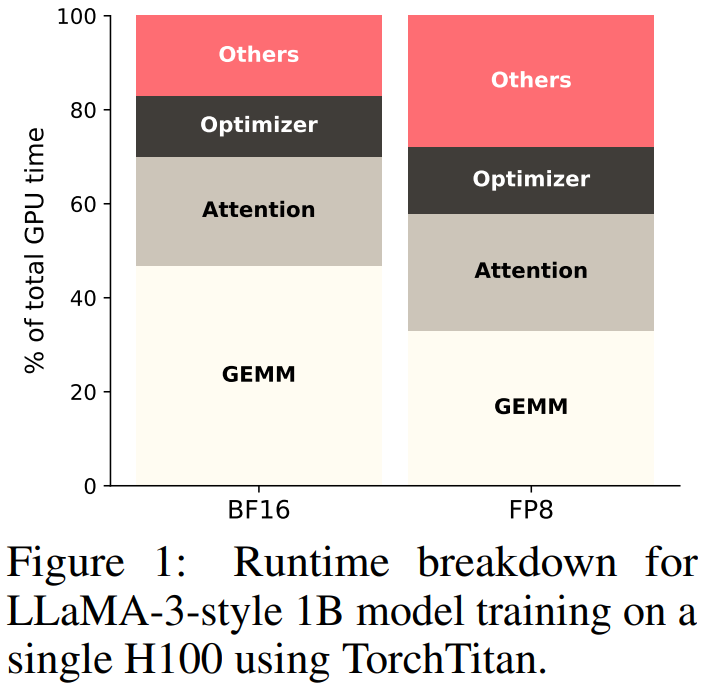
但性能分析发现,还有一大批小算子在默默消耗大量时间:RMSNorm 归一化、SwiGLU 激活、RoPE 旋转位置编码、残差加法、交叉熵损失等等。
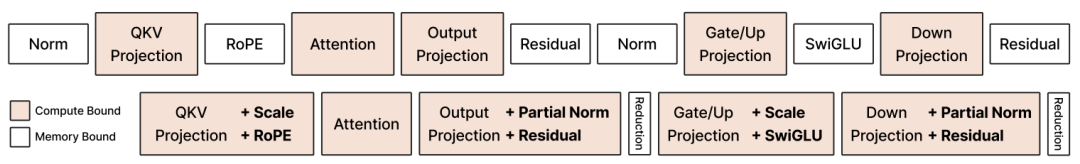
这些操作虽计算量小,但频繁把大中间结果在显存和片上寄存器间搬运,造成严重的GPU 带宽瓶颈。
可以想象,一个厨师若每道菜都要到远处搬食材,哪怕烹饪速度再快,都逃不过搬运食材的偷懒税。
随着FP8/FP4 低精度矩阵乘法越来越快,搬运成本的比例反而凸显,整体训练性能提升的空间被内存开销限制住了。
传统深度学习框架通常把 Transformer 计算拆成一连串算子,算子间有清晰边界,利于自动微分,但每个边界往往意味着一次不必要的显存写回。
CODA 的核心洞察是:这些归一化、激活函数、残差相加等操作,其实可以代数变换后藏进矩阵乘法的尾声里执行,避开额外的显存往返。
GPU新思路:用GEMM的尾声做融合
在GPU上,一个高性能 GEMM 内核一般分为两部分:主循环做矩阵分块乘加,尾声在写回全局显存前做收尾操作。
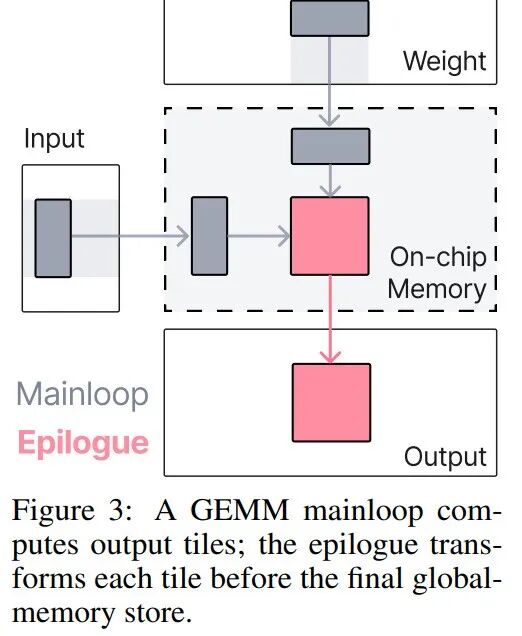
关键在于:此时GEMM的输出还留在片上寄存器中,是一个黄金时机。如果能在尾声阶段完成更多工作,就能节省一次完整的写回再读入。
CODA通过数学技巧,将许多Transformer中的内存密集操作重参数化,在尾声阶段一并计算。
常见的GEMM→RMSNorm→GEMM模式:传统做法先做一个 GEMM,写回内存;再做残差加法和行归一化;再做第二个 GEMM。
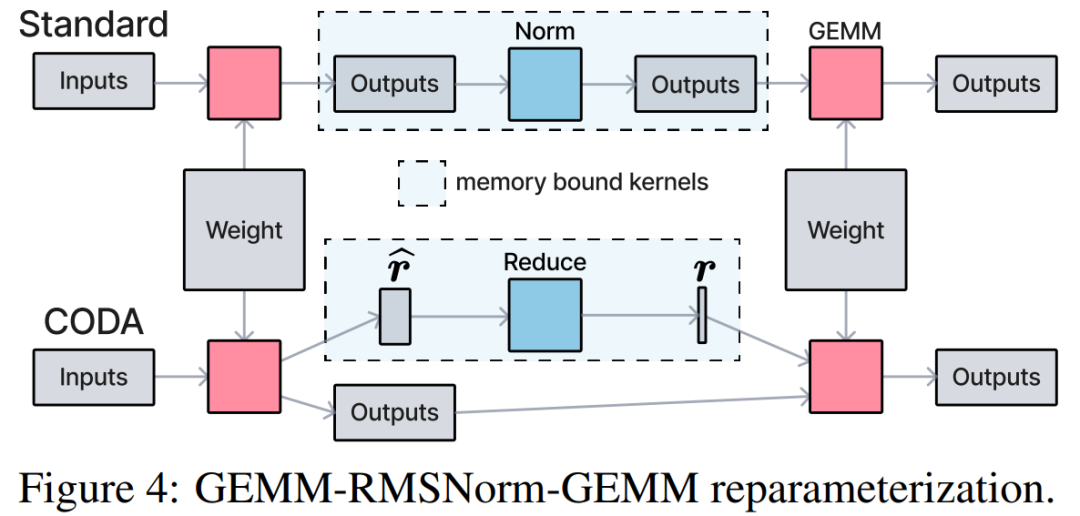
但CODA团队发现,RMSNorm中每行的缩放因子 $r$ 可以推迟应用到第二个 GEMM 的尾声里,因为 $r$ 和后续矩阵乘满足交换律。
这样,第一个 GEMM 尾声只需计算分块均方根(partial RMS),真正的RMS归一化操作延后到第二个GEMM内部完成,从而省去了中间结果写回。
类似地,SwiGLU、RoPE、交叉熵等操作,也可以用数学方法塞入尾声融合执行,甚至连反向传播都成立。CODA 论文证明,只要前向尾声是分块局部的,对应反向运算也可自然继承相同结构。
一套乐高原语:CODA编程抽象
CODA不仅是一种特定融合内核,更是一整套针对Transformer的编程抽象。
它固定住经过手工优化的 GEMM 主循环,在尾声阶段暴露出五类基本原语,如同乐高积木般可组合:
逐元素变换:
残差相加、激活函数(SwiGLU/SiLU)、RoPE 旋转编码等。
向量加载与存储:
广播RMSNorm权重到每行。
矩阵分块加载与存储:
在尾声保存局部结果,供后续反向传播使用。
分块规约:
计算局部均方根(partial RMS)、分块log-sum-exp等中间统计。
有状态变换:
维护在线归一化等所需的最大值和累加和等统计量。
利用这五类原语,CODA能覆盖标准Transformer前向与反向传播中除注意力以外的几乎所有操作。
更有趣的是,这套抽象对谁来写代码非常友好:研究团队用两种方式实现了 CODA 内核:人工手写和AI 生成。
后者由 Claude Code 大模型辅助编写。结果令人惊讶:AI 生成的CUDA 内核性能几乎与人手写的相当,有时甚至略好。
正如Tri Dao所说:“LLM以及新手就可以为所有Transformer操作编写光速内核”,这正是CODA实验在现实中的映射。
性能亮点:GPU加速效果
CODA在多项严格基准测试中表现优异。
它主要与以下优化方案对比:NVIDIA cuBLAS配合 PyTorch 和 torch.compile,以及专为大模型优化的 Liger Kernel、FlashInfer 等。
在典型模式下,CODA实现了对 cuBLAS+PyTorch 基线的全面超越。
在不同规模的模型隐藏层维度上测试,CODA 单算子性能稳定领先。类似地,尾声融合后的 SwiGLU、RoPE、交叉熵等组合也都有显著提升。
更值得一提的是反向传播:由于反向传播中间张量更多,尾声融合带来的好处更大。
实验显示,使用CODA 的反向内核在 GEMM-Residual-PartialRMS-GEMM 模式下可实现1.6–1.8 倍加速;SwiGLU 反向也有约1.4–1.6 倍提升。
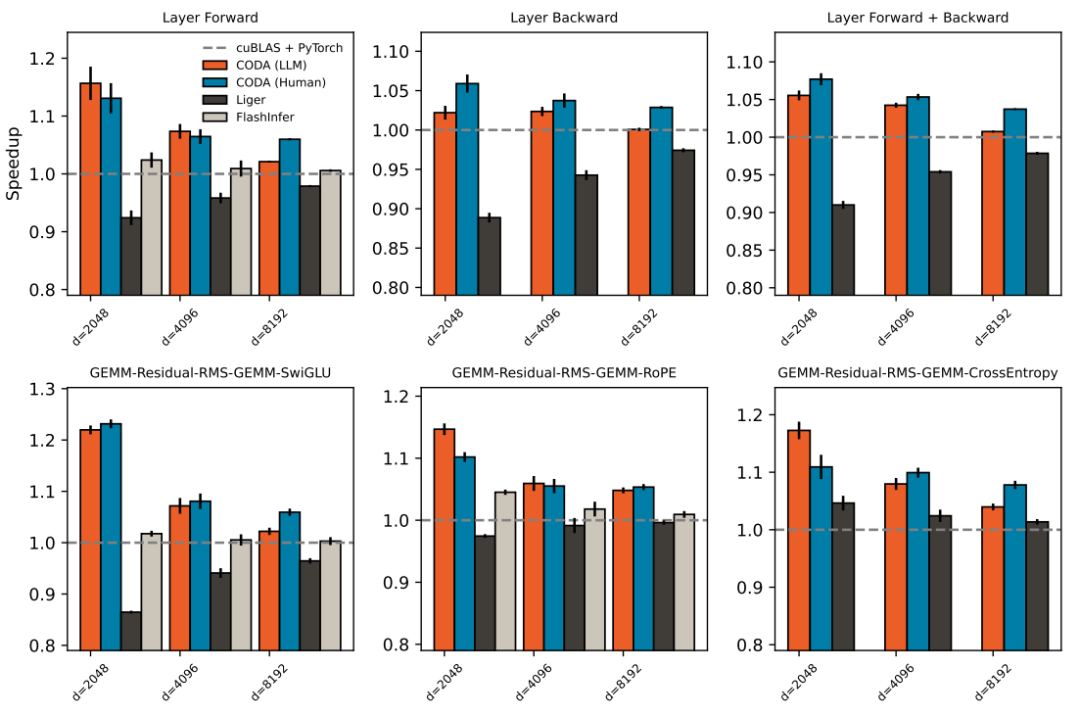
在完整 Transformer层端到端测试中,CODA的前向速度比照基线提高了约5%–20%,规模越大加速效果越明显。这意味着,对于超大模型训练,即便只提升个位数百分比的速度也非常可观。
在数值精度方面,CODA虽然改变了计算顺序,但实验表明误差与 PyTorch原始实现相当,在某些设置下误差甚至更小。这得益于GEMM 内核使用了更高精度的累加器,减少了舍入误差。
CODA的优势与限制
CODA主要适用于标准 Transformer训练,可加速几乎所有除注意力外的计算,包括 RMSNorm、残差加法、SwiGLU 激活、RoPE 旋转编码、交叉熵损失,以及它们的梯度计算。
其性能在 1B到 70B规模模型下稳定提升,尤其在反向传播上收益最大。CODA 基于 CuTeDSL实现,支持人工编写和 AI 编写内核两种模式,均能达到较高性能。
当前 CODA有一些使用限制:它只支持单 GPU场景,还没有分布式训练的集成;且其算法重参数化主要针对常见的 Transformer 架构,其他网络暂时不在覆盖范围内。
CODA 暂未替代注意力计算内核,后者仍需类似 FlashAttention 等方案来优化。不过,CODA 代表了一种思路:在 GPU 优化中,关键不只是“算什么”,更是“怎么搬算子”。
与 Triton、ThunderKittens、TileLang 等新兴框架一道,它们共同的目标是保持数据尽可能留在片上,将 PyTorch算子图的便利性和手写CUDA 的效率真正统一于一个可编程抽象。
CODA 的名字可能另有深意。在古典音乐里,Coda 是乐曲的终章,这里 CODA 则是 GEMM 内核的尾声。做好这个尾声,也许就是 Transformer 训练系统效率提升的下一个重要篇章。
正如Tri Dao所言,当编程抽象足够简洁时,AI自己也能加入优化流程,AI 与人类一起推动训练基础设施的迭代,这才是CODA最耐人寻味之处。