DeepMind又动Transformer内部管线:不改主权重,小模块反超全量微调
2026年08月27日
训练结束,Transformer的能力上限就被彻底锁死了吗?Google DeepMind最新论文《Recirculation》给出一个新答案:不继续堆参数,也不必重训整套模型,只要让深层状态重新回到较浅层,模型就能获得新的计算空间。升级版Adaptive Recirculation只训练一个小型MLP控制器,Gemma3主体权重始终冻结。在9个语言建模数据集上,它带来平均23.0%的困惑度降幅,高于全量微调的21.6%,成为一种值得关注的无需全量微调的大模型优化方案。Transformer真正缺的,可能是一条回路
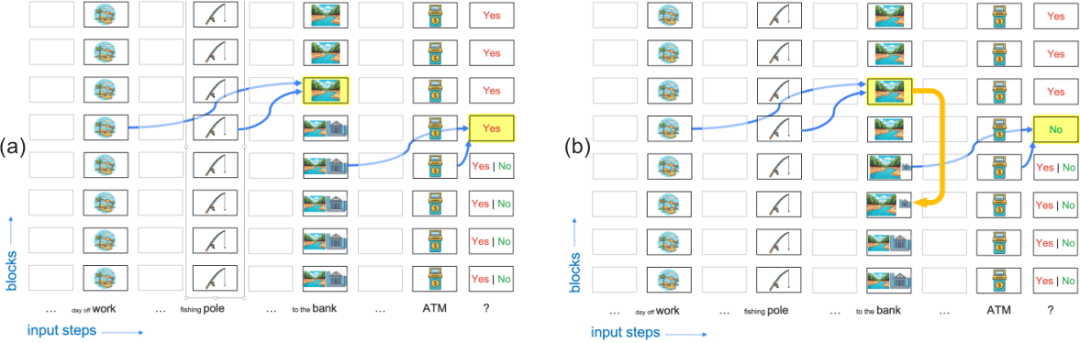
标准Transformer处理token时,信息从浅层一路流向深层。浅层识别字面和局部模式,深层再完成语义消歧与状态更新。问题在于,深层得出的新结论,不会自动回到浅层,供后续token继续调用。论文用bank举例。上文出现fishing pole时,深层已把bank理解成河岸;后面出现ATM,金融语义关联仍可能抢先影响输出。不是模型没有理解,而是深层状态没有及时进入下一轮浅层计算。此前研究显示,把完成消歧的深层表示重新注入浅层,可让这类上下文化错误减少约60%。Recirculation把一次性干预变成稳定通路,回应了大模型长上下文状态跟踪问题。深层激活,怎样重新流回来?
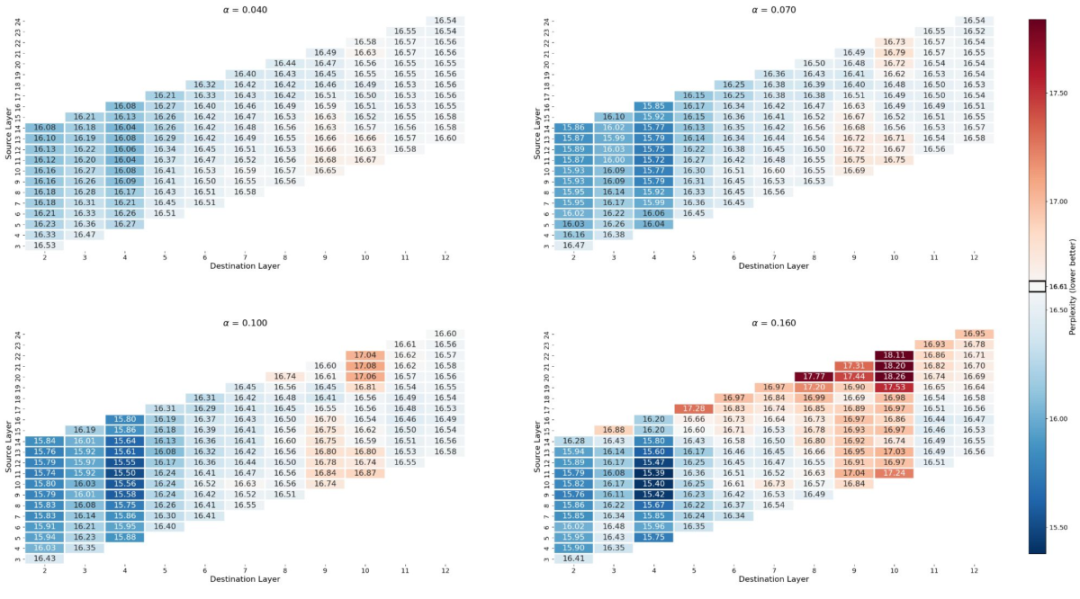
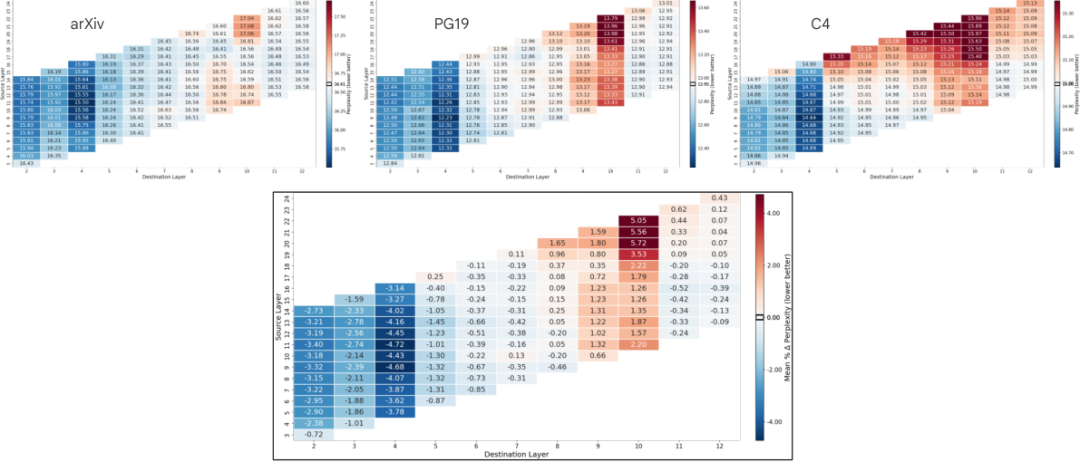
DeepMind Recirculation技术原理并不复杂。模型处理当前token时,从较深的源层读取激活,先将其L2范数对齐到较浅目标层,再与目标层原有状态混合。两个系数分别决定回流多少和保留多少。这种Transformer深层激活回流机制之所以可行,与残差流有关。不同层在同一通道上读写,像共享一块黑板。因此,Transformer残差流信息回流不必建立复杂的跨层翻译器。在Gemma3上,较优源层→目标层组合分别是:1B模型11→4,4B模型18→9,12B模型35→16。回流存在可稳定搜索的有效区域。它不是CoT,也不是简单重复层
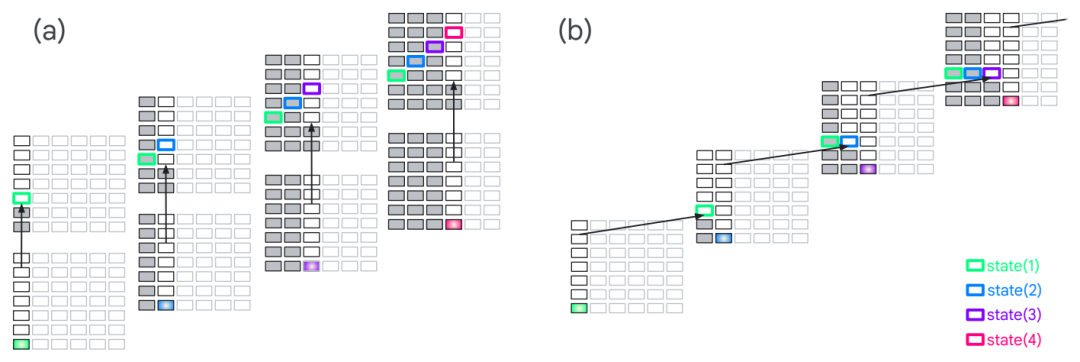
Recirculation与Looping区别很清晰。Looping主要沿网络深度重复执行若干层,相当于把同一token算得更深;Recirculation则同时跨越网络深度与token时间,让后续步骤能继续使用前面已经更新的内部状态。CoT把中间过程写成显式token;Recirculation把更新留在模型内部,更像持续维护工作记忆。对大模型推理阶段架构优化而言,这是一条不增加输出token的新路线。权重不动,性能已经被重新打开
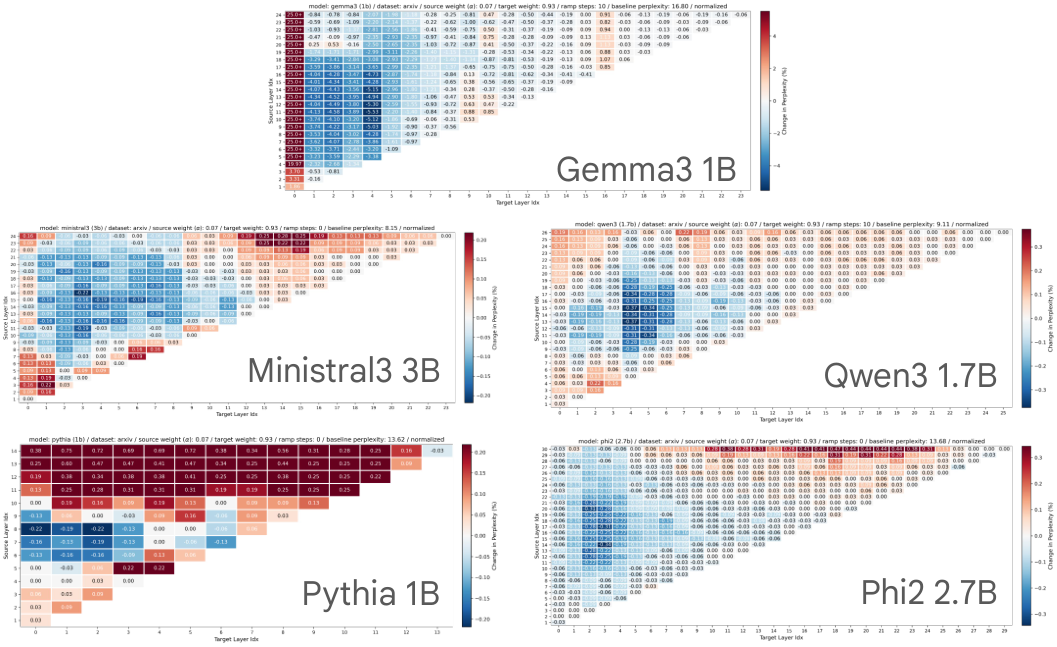
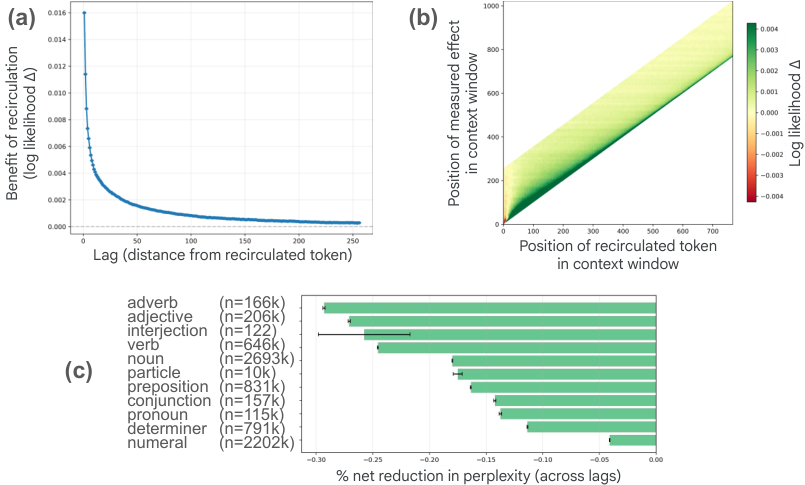
Gemma3模型性能优化结果非常直观。团队在1B、4B、12B三个规模、10个语言建模数据集上测试基础Recirculation,其中9个数据集呈现跨规模改善。以Gemma3 12B为例,PG19困惑度下降35.40%,BookSum下降32.91%,GovReport下降30.74%。研究还扩展到Qwen3 1.7B、Pythia 1B、Ministral3 3B和Phi2 2.7B,五个模型家族都能找到有效的深层到浅层回流区域。这让大模型困惑度降低方法多了一个新选项:让已训练模型更充分地复用自己的深层表示。单个token回流的收益在相隔256个token时仍可测到;副词、形容词和动词改善更明显,说明它在持续影响与语境相关的内部表示。指令遵循实验也出现清晰改善,显示深层状态回流能够帮助模型持续执行上下文中的规则。## 小型MLP,为每个token决定回流多少
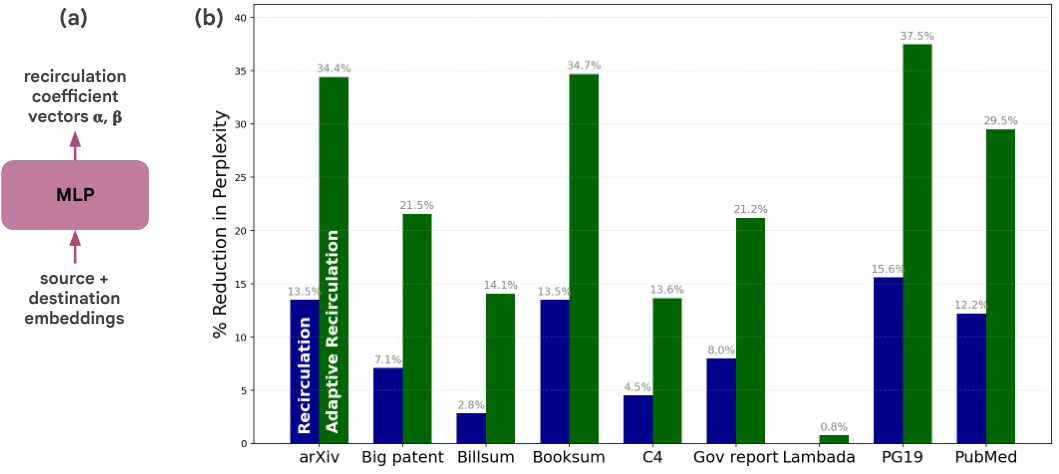
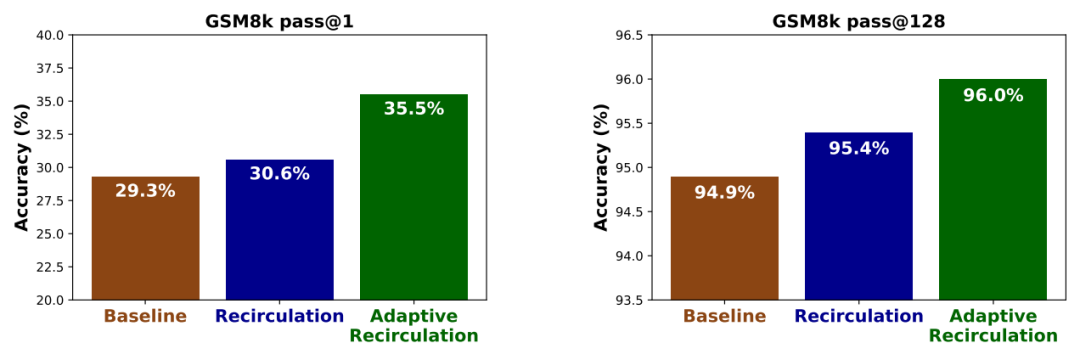
固定系数对所有token一视同仁,而真实语境显然需要更细腻的控制。于是,Adaptive Recirculation方法加入一个轻量MLP,根据当前token在源层与目标层的表示,动态生成逐维混合系数。逐维控制优于单一标量,token条件控制又优于固定参数。基础Recirculation平均降幅为8.5%,Adaptive Recirculation达到23.0%,全量微调为21.6%。主模型完全冻结,验证了冻结大模型权重提升性能。数学推理同样出现提升。Gemma3 4B在GSM8K上的pass@1从29.3%升至35.5%,相对提升约21%;pass@128从94.9%升至96.0%。这组GSM8K数学推理性能提升数据说明,回流不仅能改善文本预测,也能支持更长的生成式推理过程。下一轮模型竞争,可能从堆参数转向改信息流
Recirculation带来的启发,是模型训练完成后,架构仍有可塑空间。权重保存了能力,信息流决定这些能力何时被调用、如何被复用。对工程团队而言,它打开了三条思路:在推理阶段重组状态传播;用轻量控制器替代大范围参数更新;让模型按token内容动态分配计算。自回归生成阶段,两套Transformer可并行执行,额外生成延迟几乎可以忽略。从大模型推理效率优化到轻量化大模型微调,Recirculation给出一个鲜明信号:下一次性能跃迁,也可能来自一条更聪明的信息回路。