不到20天,拿下国内、全球两个第一:文心助手把AI从会答推向会交付
2026年08月06日
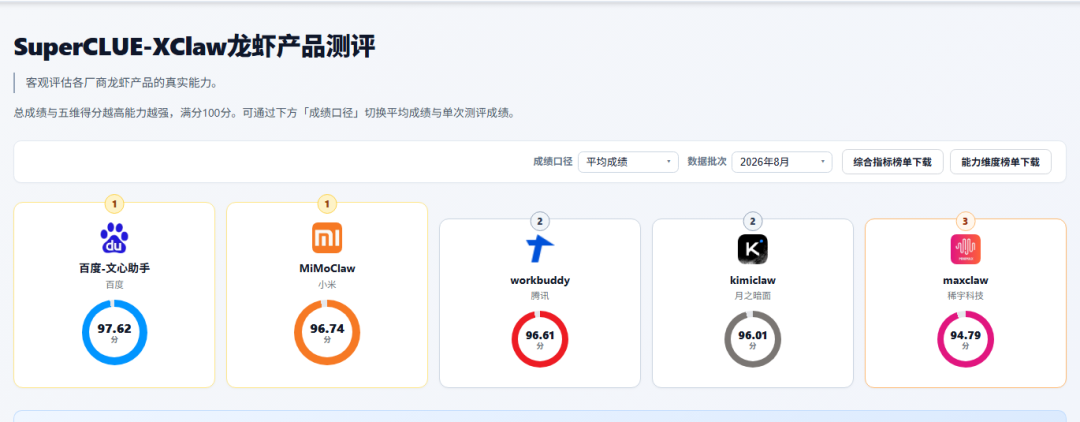
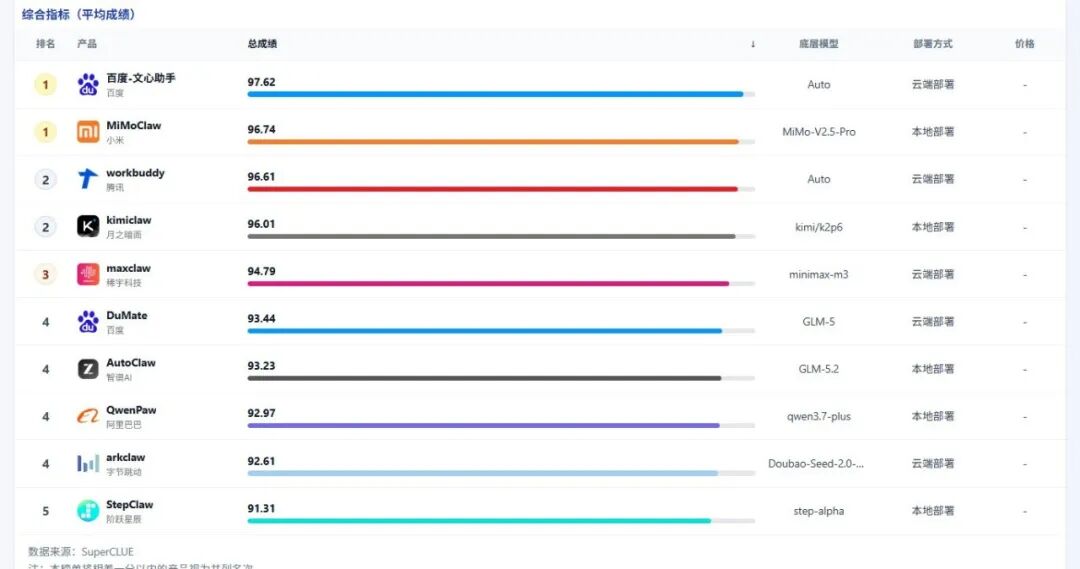
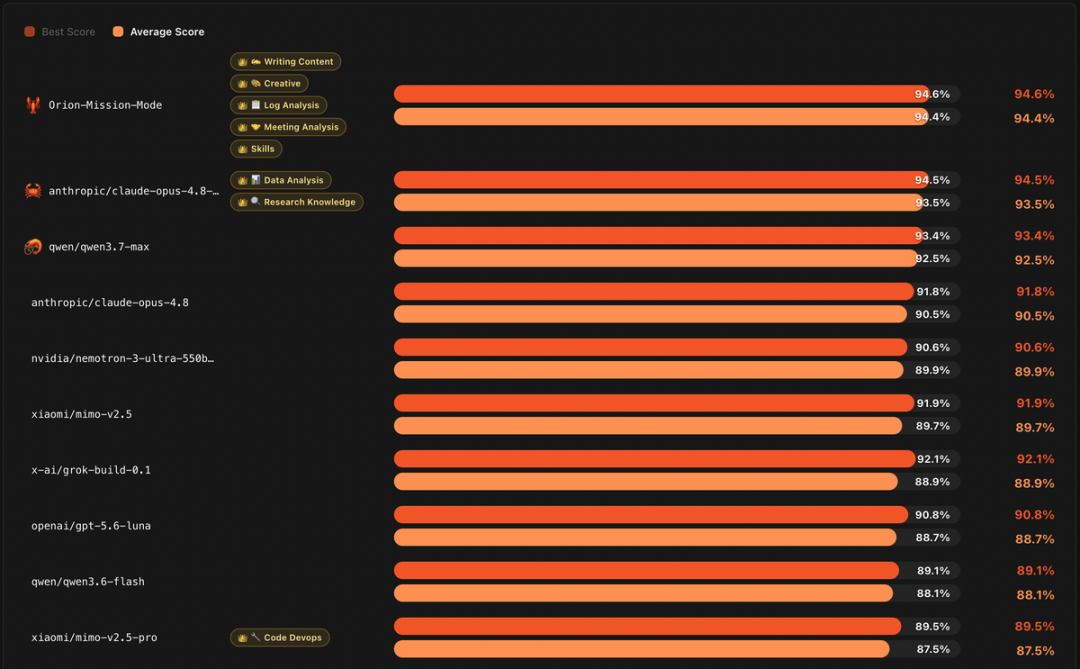
如果说过去的大模型比的是谁更会回答,那么2026年的AI智能体,真正比的是谁能把事办成。就在不到20天里,百度文心助手连续交出两张高分成绩单:一张来自中文场景,一张来自全球赛场。最新一期 SuperCLUE XClaw龙虾产品测评中,10款国产龙虾产品同台实战,文心助手以97.62分拿到全场最高原始总分。再往前看,7月17日的 PinchBench v2全球排行榜快照里,文心助手任务Agent又以最高94.6%、平均94.4%的成绩登顶。两个第一指向同一件事:AI的价值,正在从给答案走向交成果。这次第一,难在只看交付
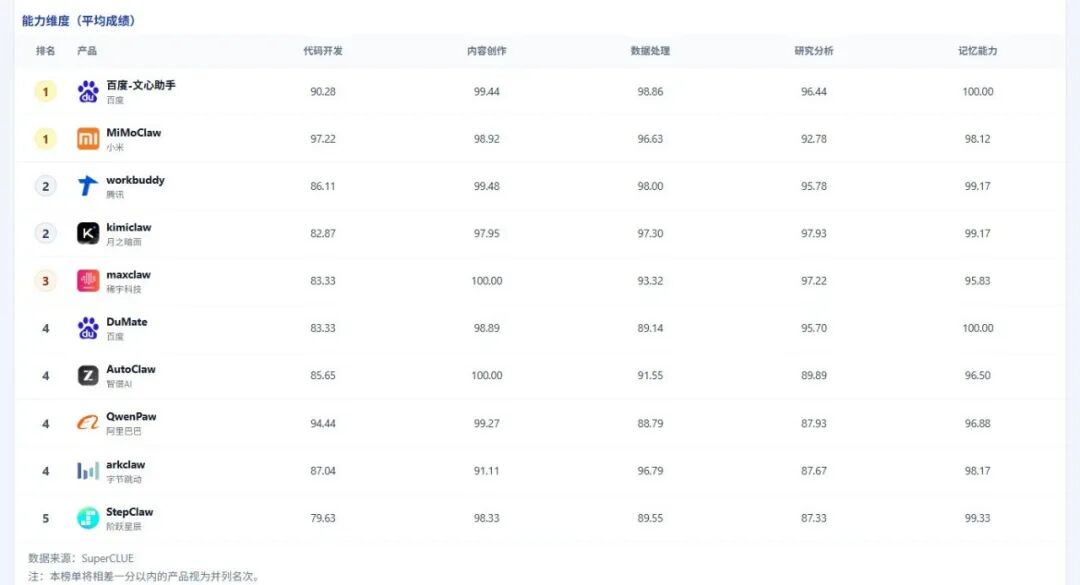
很多人搜索国产AI智能体排行榜,想看的并不是一串参数,而是哪款产品能真正完成工作。XClaw的评测覆盖代码开发、内容创作、数据处理、研究分析、记忆能力五个维度,满分100分,核心关注产品在真实任务中的最终表现。文心助手的五维成绩分别是:代码开发90.28分、内容创作99.44分、数据处理98.86分、研究分析96.44分、记忆能力100分。尤其文心助手记忆能力100分这一项,很容易被低估。Agent处理复杂任务,往往要经历多轮沟通、多个文件和多步执行。它既要记住第一轮的目标,也要保留后续新增的格式、口径和截止时间。记忆一旦断掉,前面的工作就可能重来。满分意味着,文心助手能更稳地接住长链路任务,让用户少做重复说明。98.86分的数据处理,解决的是错一个数都不行
如果你正在找AI数据处理工具推荐,真正值得关注的不是它会不会画一张漂亮图,而是能否理解字段、统一口径、完成跨表汇总,并保留必要精度。XClaw中,文心助手的数据处理得分98.86,位列参评产品第一。这类任务没有太多差不多:列名映射错了、分类口径偏了、小数被随手取整,都会影响后续结论。实测中,把职业数据表交给文心助手,它可以从清洗表头、建立汇总Sheet,到生成Top10/Bottom10榜单与可视化图表,一条任务链完整跑通。所以,AI自动生成Word商业计划书也不只是把文字拼进文档。真正的交付,是先读懂资料,再搭结构、补论据、统一格式,最后给出一份能继续修改、能直接汇报的Word文件。对于日常办公,这种从原始材料到完整成品的闭环,远比单次问答更有价值。更重要的是,数据处理往往不是孤立环节。清洗后的表格要进入报告,报告里的结论要对应图表,图表又要与原始数据保持一致。文心助手把这些步骤放在一条任务链里执行,用户看到的就不再是一堆分散的中间答案,而是一套逻辑连贯、口径统一的成果包。这也是97.62分最直观的含义:不仅某个步骤做得好,前后环节也能接得上。从写内容、做网页,到完成深度研究
99.44分的内容创作能力,意味着它不仅能写,还能按照指定语气、篇幅、结构和用途交付。比如AI制作3D太阳系模拟器这类需求,考验的就是页面结构、可视化效果、交互逻辑和知识内容能否一次组合起来。用户不必先学会拆解技术需求,只要说清想要的效果,Agent就能规划实现路径。研究分析则更考验搜索、判断与整合。用户寻找AI深度研究报告生成工具,通常不是想要一篇看起来完整的文章,而是希望它能自主检索多源资料、交叉核验关键数据,再输出结构化报告。文心助手在这一项拿到96.44分,背后体现的是信息检索与任务编排的协同能力。在真实研究任务中,它可以先规划步骤,再进行多智能体并行研究分析,把资料搜索、数据核验、观点整理和可视化交给不同子任务处理。无论是旅行方案、行业分析,还是定期追踪AI论文,最终交付的不只是结论,还包括表格、图表、HTML报告等可继续使用的成果。对企业和个人来说,这种能力的价值很具体。市场人员可以把竞品资料变成分析简报,运营人员可以把多份表格变成周报,教师可以把知识点变成交互式网页,研究者也可以让AI先完成资料初筛与结构整理。任务不同,但判断标准一致:结果能否被验证、被编辑、被继续使用。59个参评模型里,历史榜单快照拿下全球第一
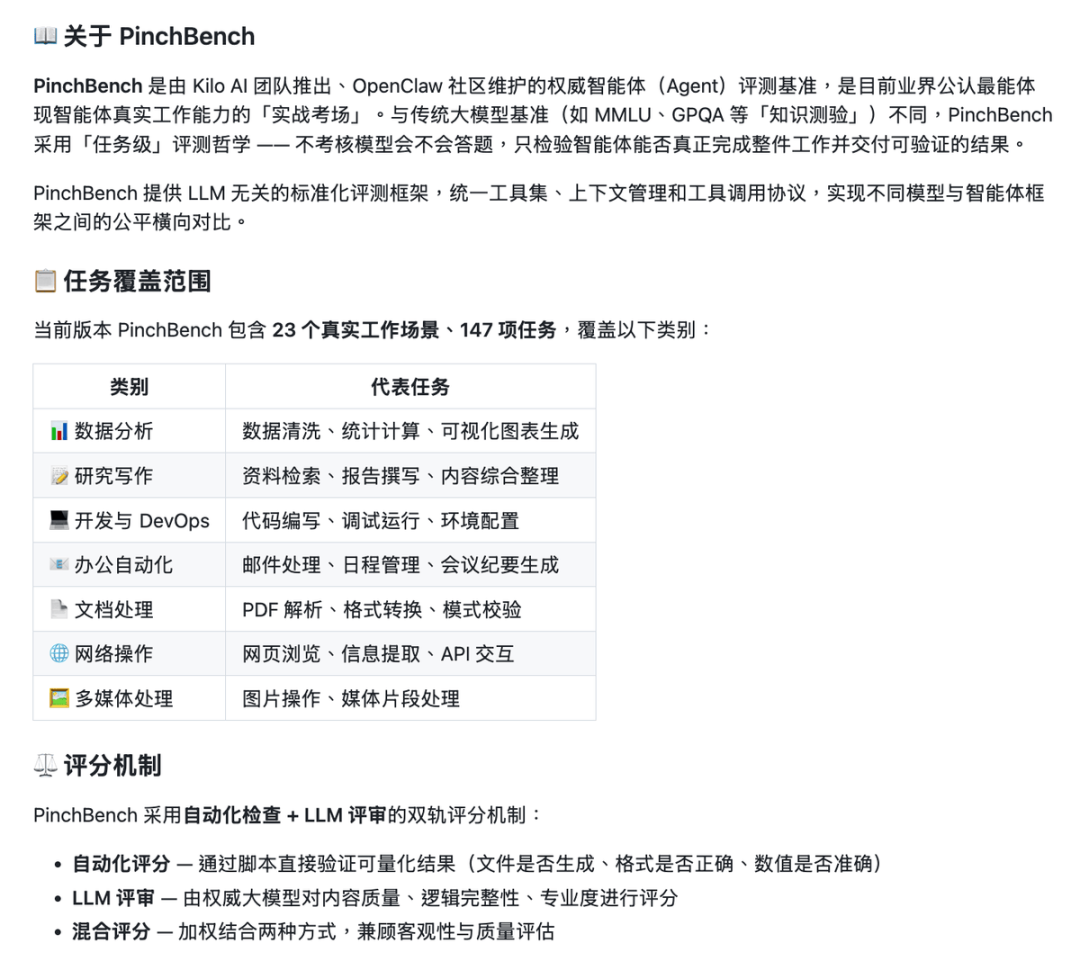
如果说XClaw回答了中文场景下谁更能干活,那么PinchBench回答的是放到全球工程化任务中还能不能保持稳定。在7月17日对应的榜单快照中,文心助手任务Agent以最高94.6%、平均94.4%位列第一,参评范围包括59个模型。PinchBench关注数据分析、研究写作、开发与DevOps、办公自动化、文档处理、网络操作和多媒体处理等任务,并结合自动化检查与大模型评审。它考察的是完整流程,而不是某一道题答得漂亮。最高分与平均分只差0.2个百分点,也让AI长程任务执行能力有了更直观的稳定性注脚。百度做了26年搜索,恰好练出了Agent需要的骨架
为什么文心助手能在两套不同的中文大模型Agent测评中连续拿高分?一个重要原因,是搜索与Agent的底层流程天然相似:理解用户意图、拆解问题、调用信息或工具、筛选结果,再完成整合交付。搜索时代,系统处理的是一个query;Agent时代,系统接到的是一个目标。工具从索引库扩展到浏览器、代码环境、文档处理器和实时接口,输出也从链接列表升级为报告、表格、网页与可执行文件。百度长期积累的意图理解、信息检索和结果排序能力,正好可以迁移到任务执行链路上。这也是为什么,今天再讨论文心助手任务Agent,重点已经不只是底层模型有多强,而是模型、搜索、工具、记忆和多步规划能否一起工作。从用户视角看,最明显的变化是操作方式变简单了。过去要分别打开搜索、表格、文档和网页工具,现在只需说明目标、提供材料,再确认最终格式。复杂能力被藏在后台,留给人的只是一次自然语言交代和一份完整交付。两个第一的意义,不只是一张榜单换了名字,而是AI的评价标准真的变了:从回答得像不像,走向事情有没有完成。下一次遇到报告、表格、研究或网页任务,不妨把完整目标交给文心助手,看看它能不能把你的待办,直接变成成品。