Agent终于有了第二种大脑:LLaDA2.2边行动边纠错,128K上下文驶入扩散赛道
2026年07月31日
过去几年的AI Agent大多沿着同一条轨道前进,LLaDA2.2则在旁边铺出了一条新线。ChatGPT、Claude等主流Agent背后,普遍采用从前往后逐Token生成的自回归语言模型。如今,inclusionAI团队发布并开源LLaDA2.2-flash,把块并行生成的扩散语言模型带进长程智能体任务。团队将其定位为全球首个大规模Agentic扩散模型,原生支持128K上下文,采用千亿级MoE架构。这正把扩散语言模型与自回归模型区别,从写作方式推进到任务执行方式。Agent为什么需要第二种生成方式?
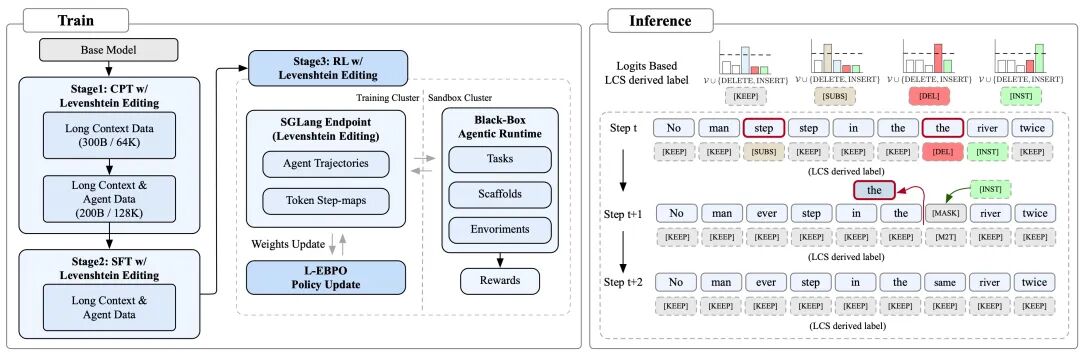
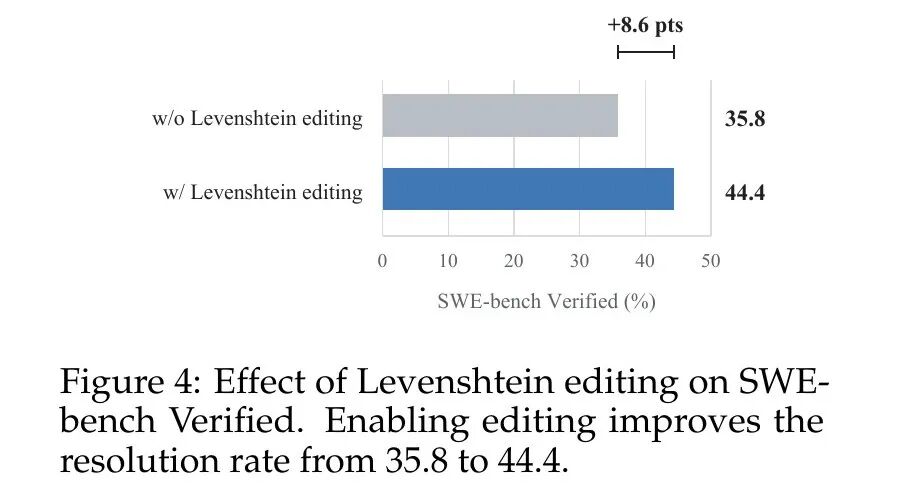
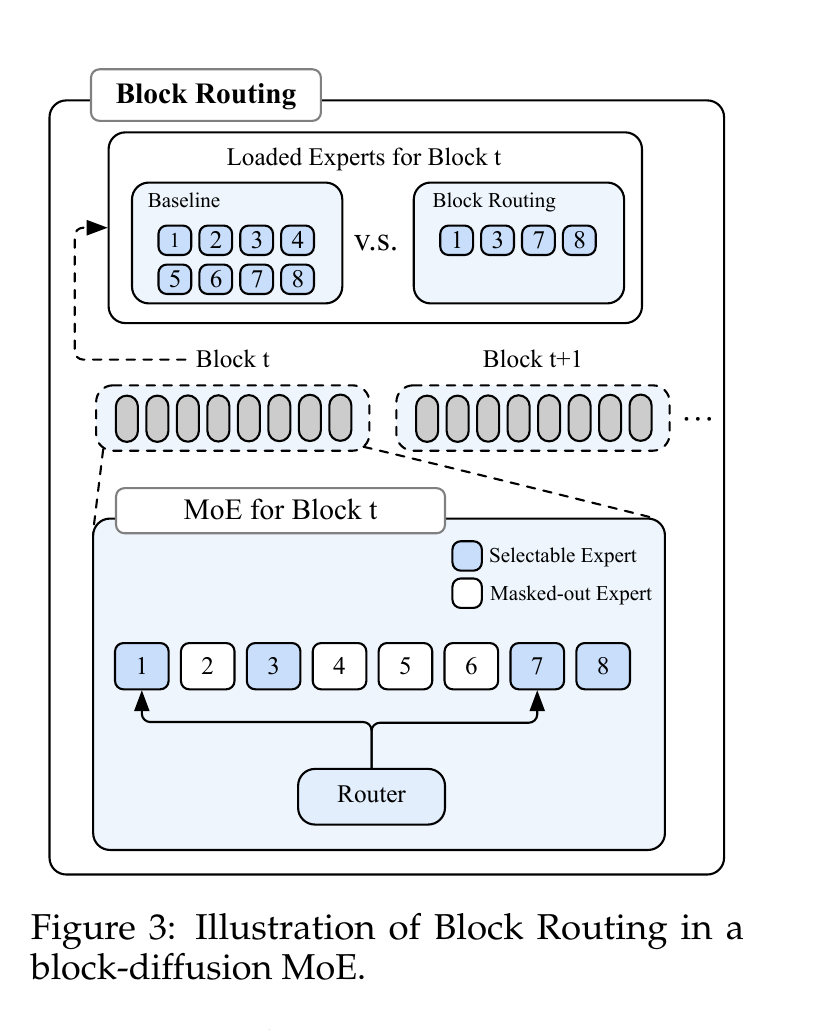
自回归模型像沿着时间线前行的作者,逐词参考前文;扩散语言模型则像协作编辑组,同时处理文本块中的多个位置,再通过多轮去噪逼近答案。并行处理带来速度空间,Agent还要理解工具返回值、维护状态并调整动作。于是,Agent边行动边纠错成为走向真实交互的关键。LLaDA2.2给出一套完整组合:Levenshtein编辑调整文本结构,L-EBPO吸收环境奖励,128K长上下文与BlockRouting支撑长程任务。这让千亿参数MoE扩散语言模型第一次拥有更完整的Agent工作流。LLaDA2.2引入KEEP、SUBSTITUTE、DELETE、INSERT四种原子操作,并利用最长公共子序列LCS,把中间草稿和目标答案对齐。内容合适就KEEP,需要更新就SUBSTITUTE,遇到冗余用DELETE移除,发现信息缺位则由INSERT创建新位置,再交给后续去噪步骤补全。这套Levenshtein编辑扩散模型机制,让生成从固定长度改字升级为动态调整结构。在SWE-bench Verified对照实验中,启用后得分从35.8升至44.4,提升8.6个百分点,可变长度编辑的价值清晰可见。Agent的每一步都会得到执行、格式和任务完成度等反馈。LLaDA2.2提出L-EBPO强化学习算法,把环境奖励带回编辑决策,让模型学习何时删除、何时插入、怎样选择更合适的动作。如果Levenshtein编辑提供了工具,L-EBPO就像导航系统:一边接收路况,一边修正路线。由此,扩散模型Agent工具调用形成行动—反馈—调整—再行动的闭环,为客服协同、软件工程和数据分析等长程任务带来新空间。复杂Agent往往需要读懂长文档、代码仓库、历史对话与工具日志。LLaDA2.2通过渐进式训练,把上下文从8K扩展到64K,再推进到128K,成为更适合长任务的128K上下文Agent模型。上下文越长,MoE专家调度越需要精细。LLaDA2.2采用BlockRouting MoE推理优化:先在块级筛选固定规模的专家池,再让Token在池内进行top-k路由。这样既保留专业分工,也让专家激活范围更可控,为长上下文多轮交互Agent提供稳定的计算基础。能力接近自回归,吞吐量打开新空间
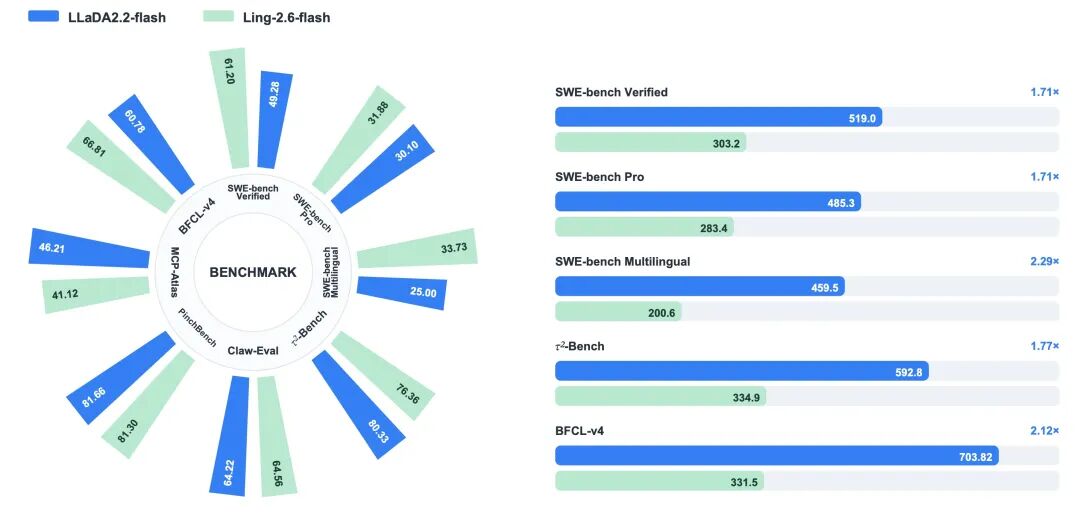
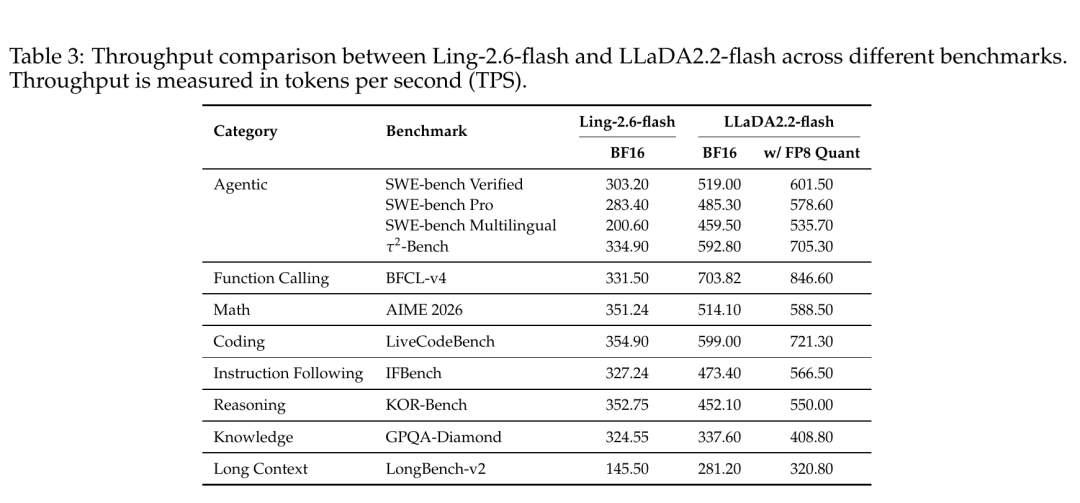
在官方技术报告列出的7项Agent基准中,LLaDA2.2-flash平均得分53.83,Ling-2.6-flash为55.74,两者差距不到2分。由于部分基准采用的评测脚手架不同,这组数据更适合观察整体趋势。进一步看,LLaDA2.2-flash在τ²-Bench、PinchBench和MCP-Atlas三项交互式任务上取得更高分数,展现出真实互动场景中的潜力。这组LLaDA2.2和Ling-2.6-flash对比更亮眼的部分在效率。覆盖11类工作负载时,LLaDA2.2-flash的BF16平均吞吐量达到Ling-2.6-flash的1.64倍;切换到FP8量化后,平均吞吐量还能再提升18.6%。在SWE-bench Multilingual上,报告给出的吞吐量对比达到459.5 TPS对200.6 TPS。速度、上下文与互动能力开始汇合,也让Agentic扩散语言模型开源项目走向可验证、可下载、可部署的新阶段。目前,LLaDA2.2-flash开源模型下载已在Hugging Face开放,技术报告和代码也已发布。Agent的未来,可能是一套双轨系统
LLaDA2.2让两种生成机制各展所长:需要严格顺序、精确格式与强因果流程时,自回归模型稳步推进;需要并行探索、快速生成和动态编辑时,扩散模型发挥效率优势。未来的Agent系统,或许会按任务阶段自动切换:规划时并行探索,执行时保持顺序,收到反馈后再进入可编辑的修正过程。自回归与扩散双轨Agent架构,有望连接高质量推理与高效率执行。从LLaDA2.0的千亿参数,到LLaDA2.1的Token级边写边改,再到LLaDA2.2进入多轮工具调用与环境反馈强化学习,扩散语言模型的路线愈发清晰。AI Agent的下一程,正在从只会一步步生成,走向能够并行思考、持续编辑、实时调整。