3万亿参数级开源时代来了:Kimi K3把前沿智能送到每个人手中 2026年07月29日
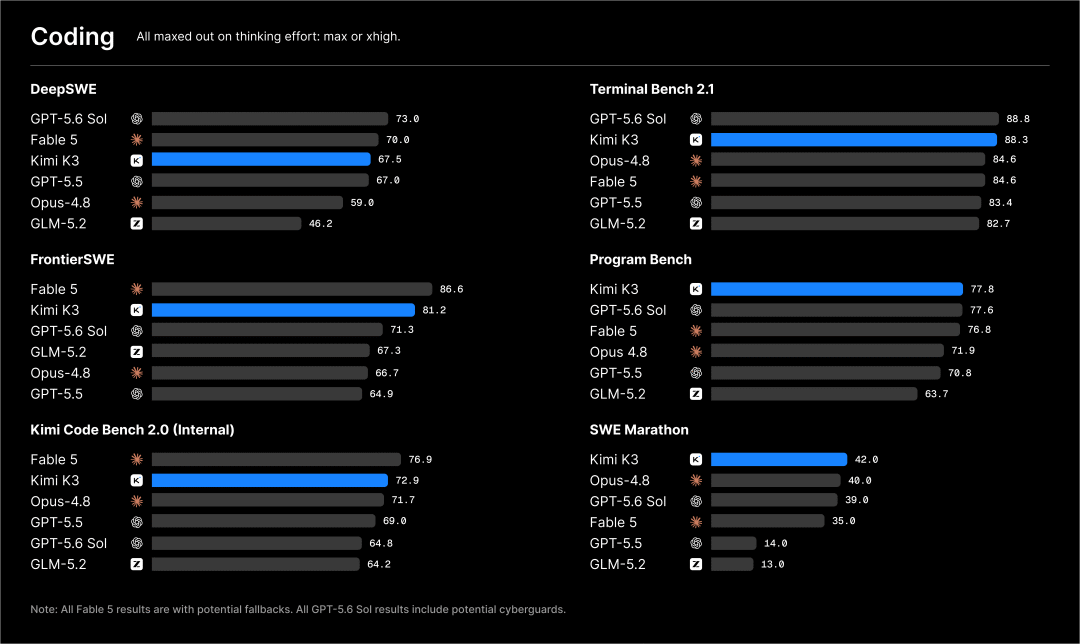
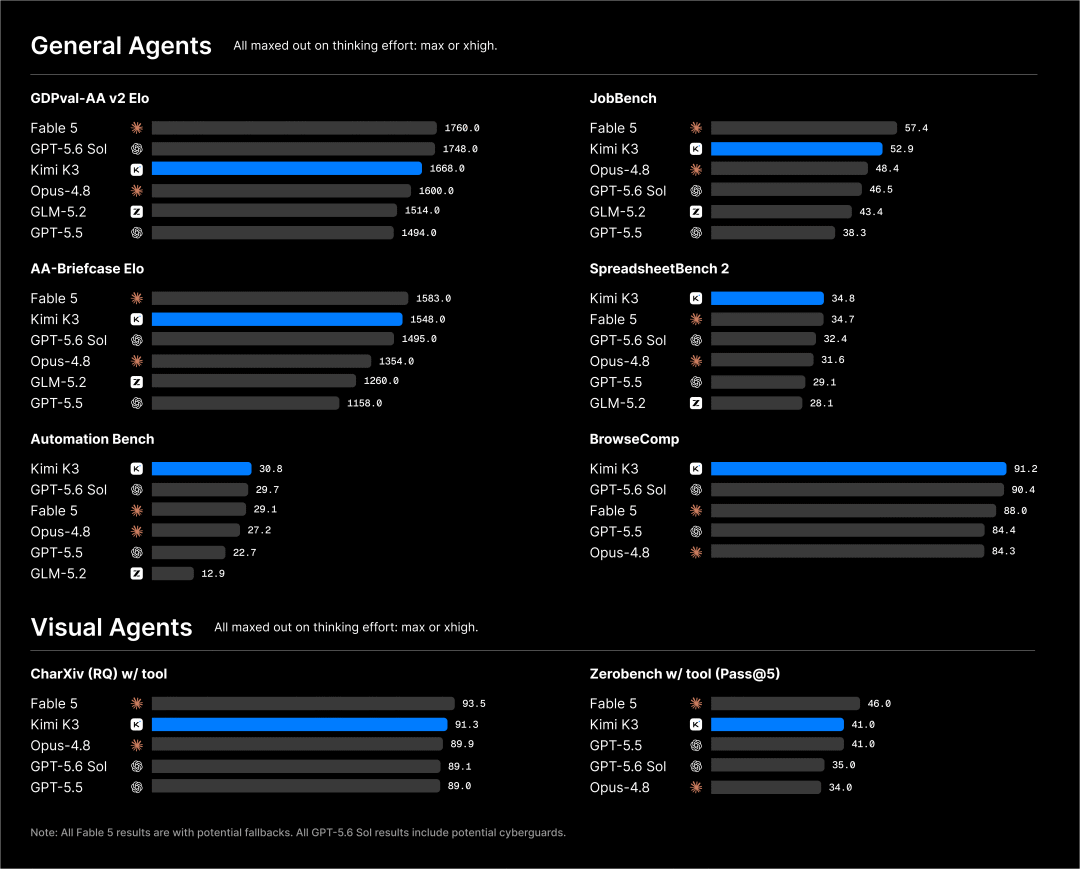
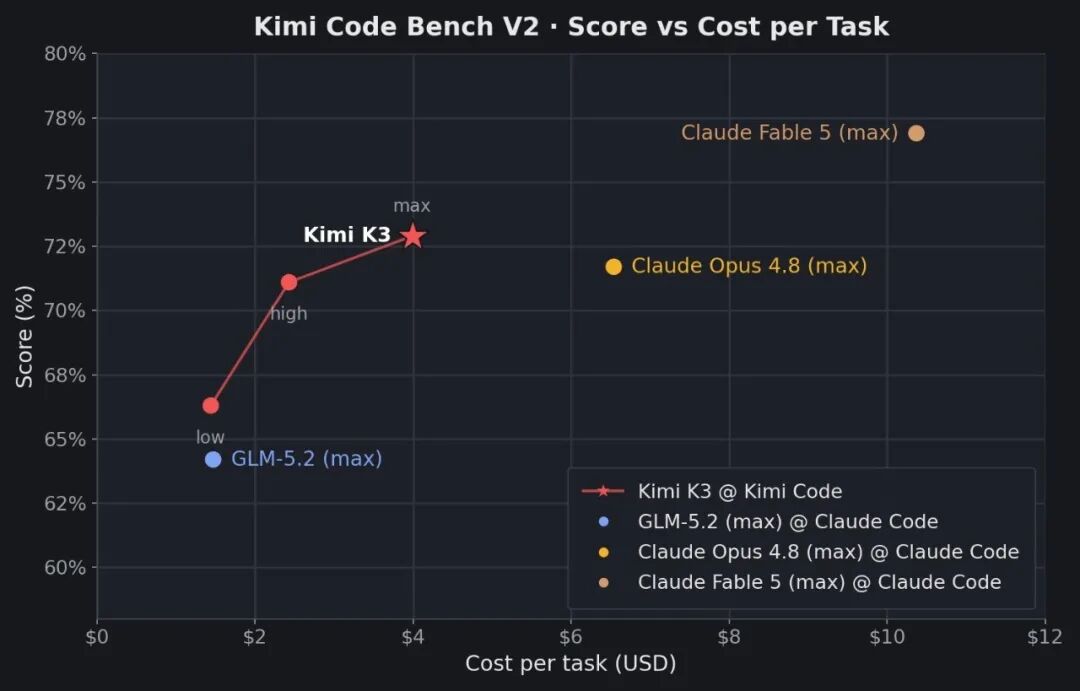
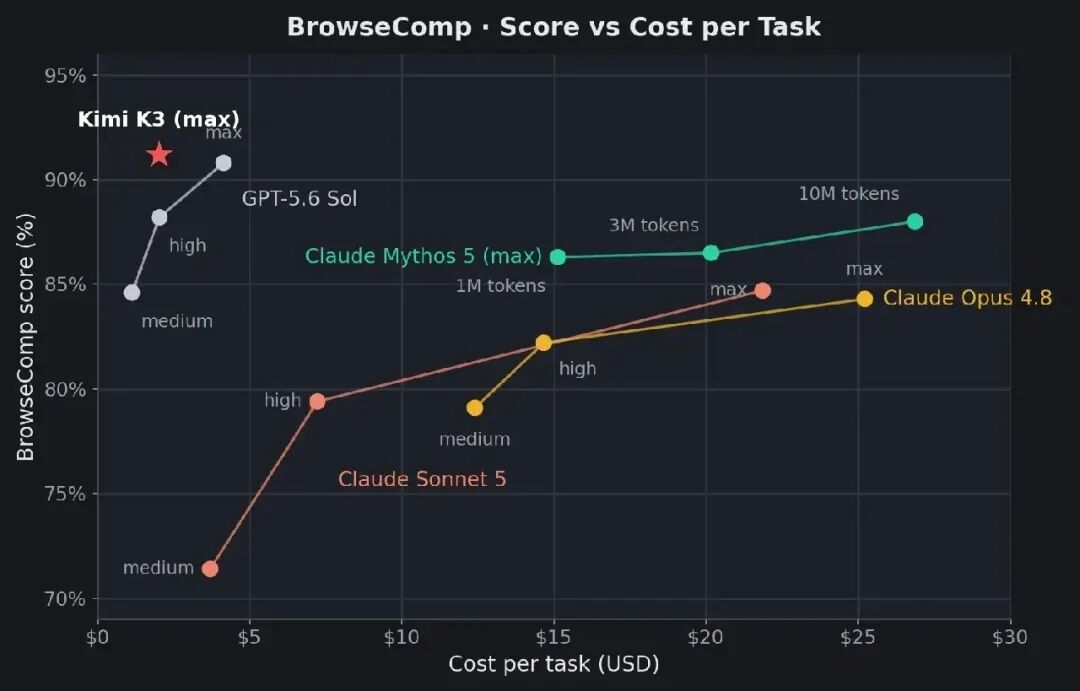
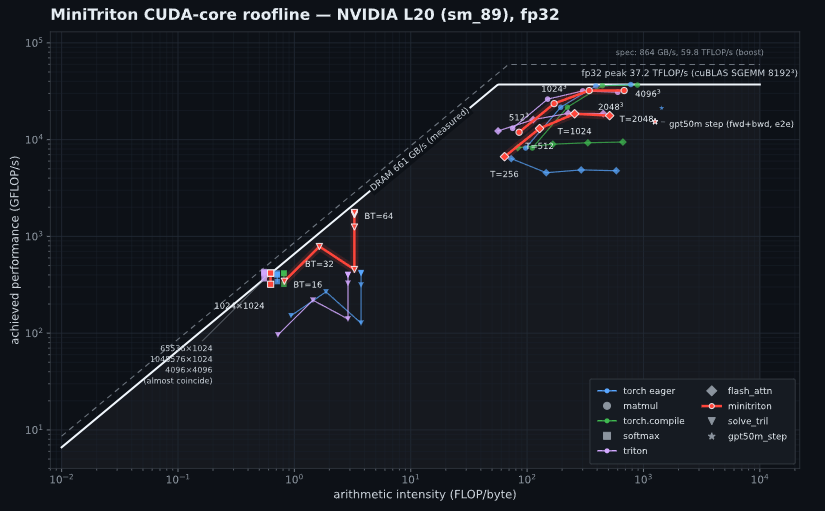
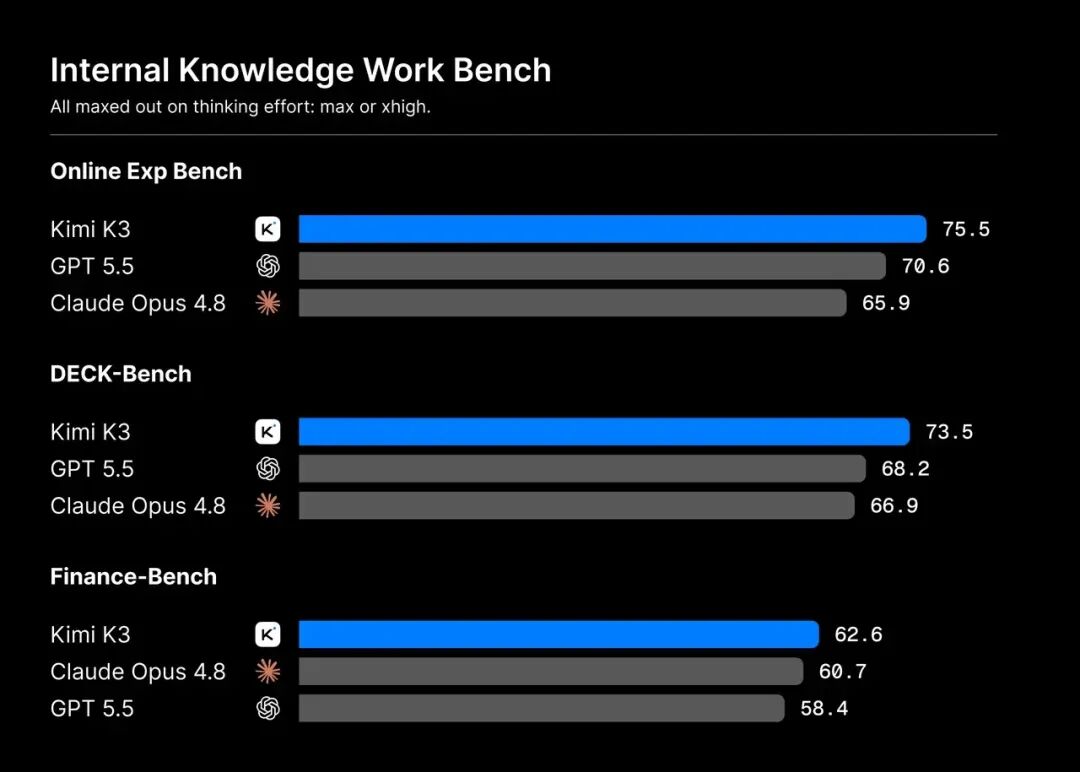
2026年7月27日,Moonshot AI正式开放Kimi K3 模型权重与技术报告。 这个总参数量达到2.8万亿、每个Token激活1040亿参数的原生多模态MoE模型,被官方称为全球首个开放权重的3T级模型。 Kimi K3开源模型已经登陆Hugging Face与GitHub。围绕Kimi K3模型权重下载、Kimi K3技术报告解读和Kimi K3本地部署方案,开发者有了清晰入口。它带来的不只是参数升级,更像是开源前沿智能的一次集体扩容。 过去,前沿模型的规模、超长上下文和复杂Agent能力,往往集中在少数商业系统中。 K3把完整权重和关键技术细节带到社区,意味着研究机构可以分析它的架构,开发者可以进行适配和二次开发,企业也可以探索面向自身业务的知识系统与智能体方案。 为什么2.8万亿参数开源大模型如此重要? 参数量决定了模型可以容纳的知识和模式上限,但真正决定使用体验的,是每次推理需要调用多少计算。 Kimi K3采用超稀疏混合专家设计:全模型拥有896个专家,每个Token只激活16个,再通过Stable LatentMoE框架完成稳定路由。 它就像一座拥有近900个专业团队的超级研究院。每遇到一个任务,系统不会让所有团队同时工作,而是挑选最适合的16个专家协同处理。 Kimi K3 MoE架构因此兼顾2.8T级容量与104B激活参数,让模型足够大和推理可以落地同时成为可能。 更值得关注的是Kimi K3 100万Token上下文。 它可以一次处理大型代码仓库、海量文档、科研论文和长时间Agent轨迹。 对于程序员,这意味着模型可以理解更多文件之间的依赖关系;对于研究人员,它可以在更大的资料范围内寻找线索;对于企业,它则有机会成为持续工作的知识中枢。 三项创新,撑起超长上下文 第一项是KDA与Gated MLA组成的混合注意力 简单理解Kimi Delta Attention原理:KDA用固定大小的循环状态高效吸收长序列信息,减少超长上下文带来的存储压力;Gated MLA则周期性保留全局检索能力,帮助模型重新找到关键细节。 官方模型卡显示,K3的93层网络中包含69层KDA与24层Gated MLA。两者可以看成高速阅读和精准回看的组合,兼顾长文本处理效率与细节召回能力。 第二项是Attention Residuals架构 它让当前层能够更加灵活地读取不同深度的表示,改善信息在超深模型中的流动效率。 配合Quantile Balancing、SiTU-GLU等设计,提高大规模稀疏训练的稳定性。官方称,这套架构让K3相较K2的整体扩展效率提升约2.5倍。 这些创新共同解决了一个关键问题:当模型规模扩大到数万亿参数、上下文延伸至百万Token时,如何让信息依然能够高效流动,并在长时间任务中保持稳定表现。 原生多模态,让AI真正看见工作结果 401M参数的MoonViT-V2视觉编码器,让文本与图像进入统一模型。代码、截图、图表、界面和文档可以被放进同一条任务链:模型不仅能写代码,还能观察运行结果、识别界面问题并继续迭代。 对于前端开发,模型可以根据页面截图调整布局与交互;对于游戏制作,它能够观察画面效果并修改代码;对于数据分析和科研任务,它可以同时理解论文、公式、图表和可视化结果。 这种视觉进入工作闭环的能力,让K3不再只是一个文字对话模型,而更接近能够观察环境、使用工具并持续行动的多模态智能体。 从写代码,到完成真实项目 在官方最大思考强度评测中,Kimi K3在GPQA Diamond获得93.5分,在Terminal-Bench 2.1获得88.3分,在BrowseComp获得91.2分,在OmniDocBench获得91.1分。 Kimi K3编程能力、知识工作能力和视觉理解能力,由此形成了更加完整的组合。 在GPU编程任务中,K3从零搭建MiniTriton GPU编译器,打通DSL前端、IR优化、PTX代码生成和运行时的完整链路。 这表明它不只是补全几段代码,还可以理解系统目标、拆分工程模块,并在较长时间内持续推进一个复杂项目。 在芯片设计任务中,K3进行了一次48小时自主工作,使用开源EDA工具完成Nano-KPU概念芯片的设计、优化与验证。 整个过程需要在代码、芯片架构、仿真结果和时序指标之间不断往返,也展现出Kimi K3智能体应用在长逻辑链任务中的潜力。 在科研任务中,K3为复现天体物理学中的I–Love–Q关系,阅读并交叉核验20多篇论文,评估300多种状态方程,编写3000多行代码,最终生成可以继续使用的交互式研究面板。 过去需要在文献、公式、数据和程序之间反复切换的工作,被整合进一条能够持续执行的智能工作流。 这些案例展示了一种新的Agent形态:AI能够长时间调用工具、观察反馈、修正路径,并交付可以运行、验证和继续修改的成果。 技术报告所描述的AgentEnv智能体训练环境,也为这种长链路协作打下基础。未来,Kimi K3多模态智能体有望进入软件研发、行业研究、财务分析、内容生产和企业知识管理等更多场景。 开放的不只是模型,更是技术底座 与模型权重同步受到关注的,还有MoonEP专家并行与FlashKDA高性能内核。 MoonEP通过动态冗余专家、在线规划和零拷贝通信,帮助不同计算节点保持更加均衡的专家负载。FlashKDA则为KDA提供基于CUTLASS的高性能实现,让新型注意力机制拥有更坚实的工程基础。 这些基础设施决定了超大规模模型能否稳定训练和高效运行。 模型、算法、训练方法与推理技术逐步开放,既能支持研究者探索超大规模MoE和新型注意力机制,也会推动主流框架、推理服务与硬件平台加快适配。 对于开发者,K3可能带来新的代码Agent、研究助手和多模态应用;对于企业,它可以成为长上下文知识系统、自动化工作流和智能Agent集群的底座;对于开源社区,围绕K3出现的量化版本、推理框架适配、垂直模型与部署工具,也将进一步丰富3万亿参数级模型的应用生态。 Kimi K3的意义,不只在于参数数字来到2.8T,更在于前沿能力开始以开放权重的方式进入全球社区。 当模型权重、技术报告和关键基础设施被放到开发者手中,新的想法就有机会更快变成产品、研究成果和真实生产力。