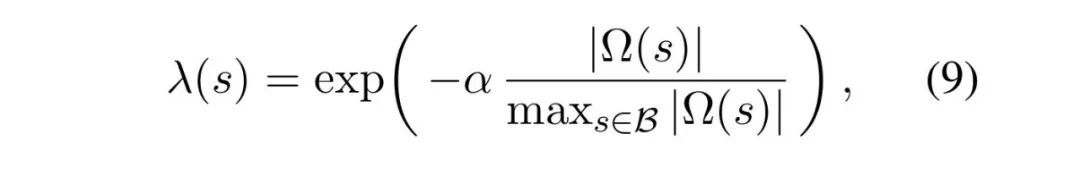大模型能力的提升,正在从继续增加训练数据,转向让模型根据反馈不断修正自己。在这一阶段,可验证奖励强化学习RLVR正逐渐成为一项重要的大模型后训练关键技术。数学题可以直接判断答案是否正确,代码可以通过测试用例检验运行结果,模型因此能够获得明确、稳定的奖励信号。也正因为如此,越来越多人开始关注:RLVR强化学习是什么,它又如何持续提升大模型的数学推理和代码生成能力?在ACL 2026会议中,浙江大学、腾讯等机构的研究团队凭借论文《Rethinking Entropy Interventions in RLVR: An Entropy Change Perspective》获得Outstanding Paper Award。这项工作从单个token的熵变化出发,重新解释RLVR训练中的策略熵动态,并提出了STEER熵稳定方法,为大模型保持探索能力提供了一种更加精细的训练思路。为什么策略熵会影响模型推理?
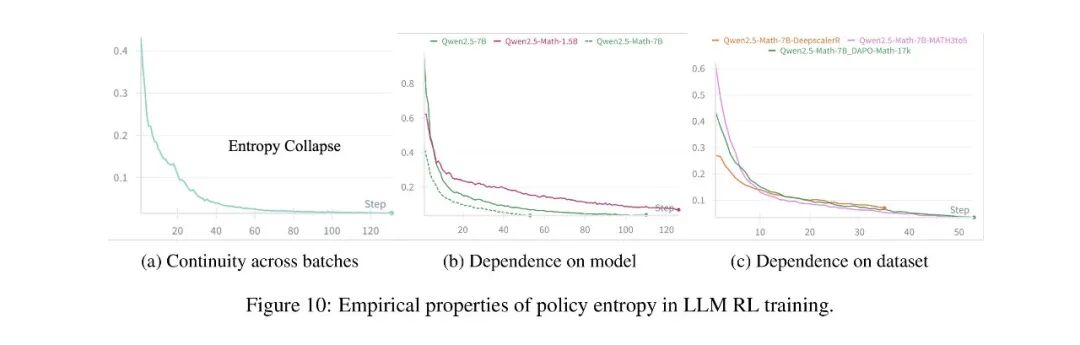
理解RLVR熵坍缩,可以先把模型的推理过程想象成一棵不断生长的树。模型每生成一个token,都相当于站在一个岔路口选择下一步。不同token对应不同推理方向,而token的概率分布,决定了模型愿意为多少条推理路径保留机会。这也是大模型推理树探索的核心。概率分布越丰富,模型保留的推理方向越多;概率越集中,模型就越倾向于沿着少数熟悉的路线继续生成。RLVR训练会不断调整这些路径。有价值的推理分支得到强化,其他分支的概率则会逐步降低。在较为理想的状态下,扩展新分支和强化有效分支能够保持动态平衡,模型既可以巩固正确方法,也能继续发现新的解题方式。随着训练持续进行,策略熵可能快速下降,模型生成的答案也会逐渐集中。对于GRPO这类group-based算法,当同一个问题采样出的回答越来越相似时,组内advantage信号的区分度也会随之降低。这正是研究者关注的GRPO训练停滞原因之一。从单个token看清策略熵变化
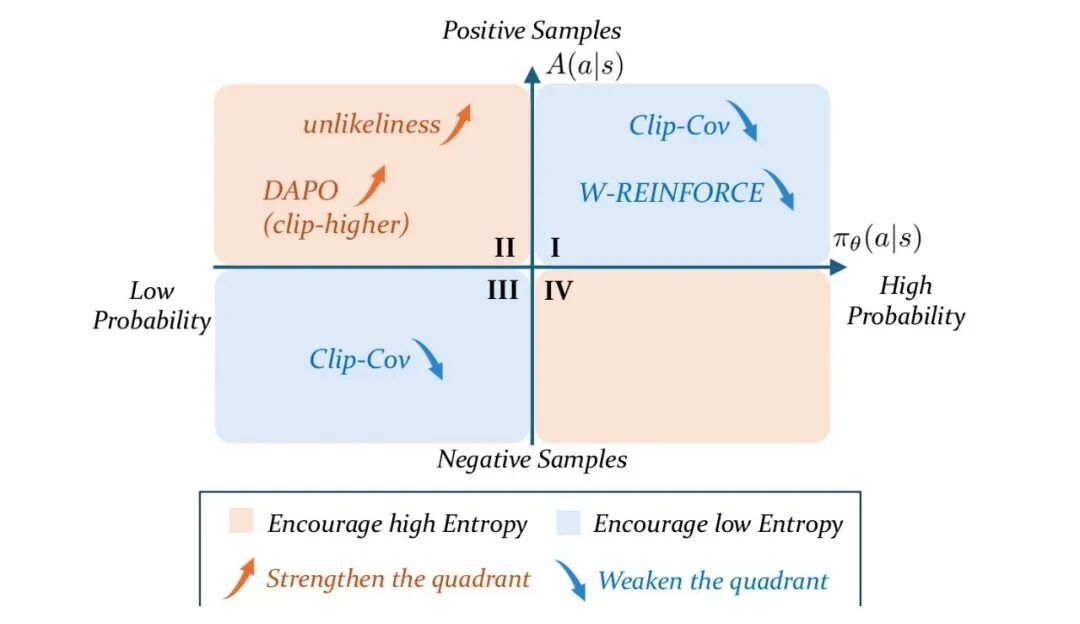
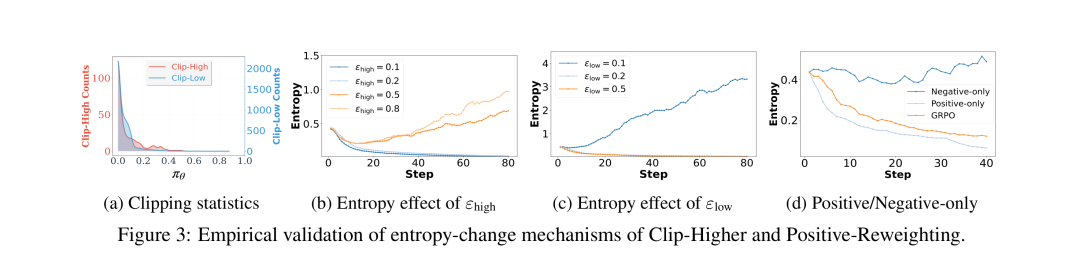
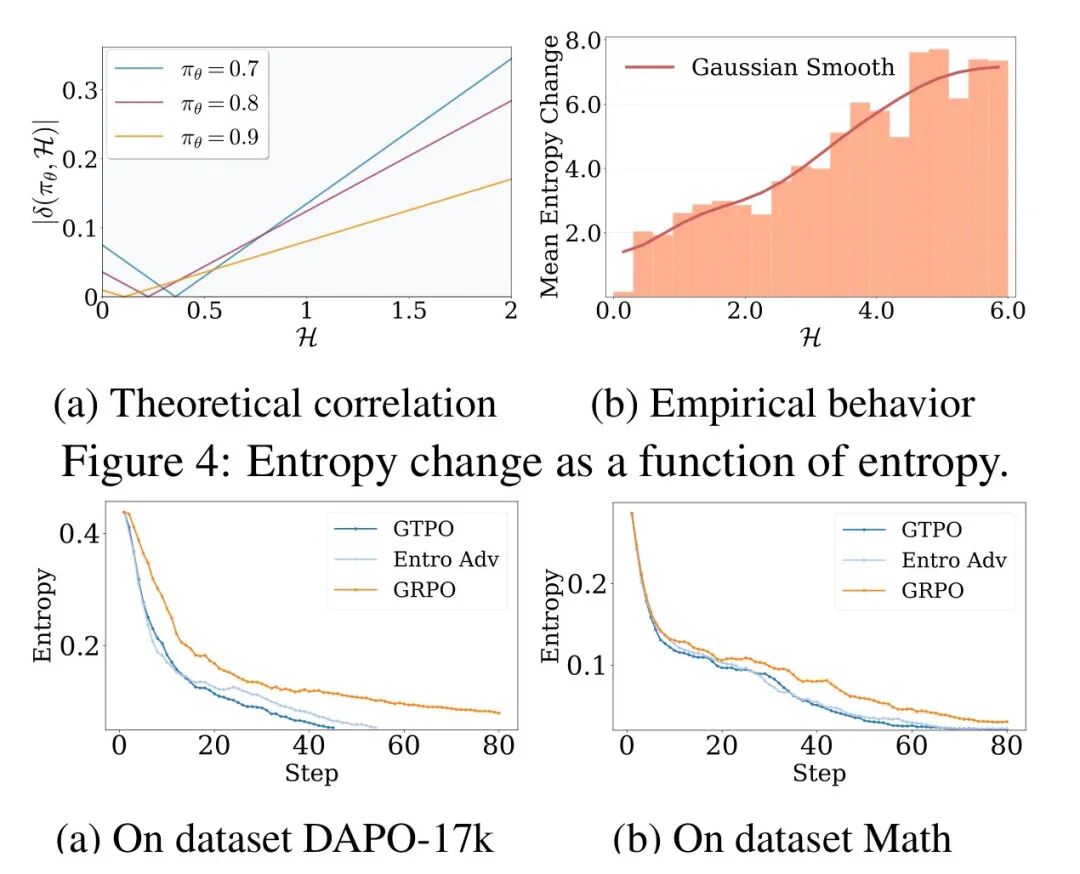
过去,人们通常通过整体训练曲线分析策略熵下降原因。这篇论文则进一步把观察粒度推进到单个token:一次参数更新,究竟会让当前状态下的局部熵上升还是下降?通过token-level熵变分析,作者发现,一次token更新主要受到四个因素影响:clipping是否截断更新、advantage是正还是负、token原本的生成概率,以及当前上下文中的条件熵。其中,最关键的是advantage与token生成概率的组合。当一个高概率的正确token被继续强化时,模型会更加确信已有路径,概率分布随之集中,局部熵趋于下降。当一个低概率但正确的token被强化时,模型相当于保留了一条少见但有效的新路径,局部熵反而可能上升。负样本也存在类似机制。降低高概率错误token的权重,可能为其他路径释放更多概率空间;降低低概率错误token的权重,则更接近对推理树进行精准剪枝。通过这种方式,大模型探索空间收缩不再只是训练曲线上的宏观现象,而成为一个可以计算、比较和干预的训练过程。现有熵干预方法为什么有效?
例如,DAPO和Clip-Higher会让更多低概率但正确的token参与更新,相当于为“少见但有效”的推理路径保留成长空间。Positive-Reweighting会降低高概率正样本的训练权重,减少模型对熟悉路径的重复强化,同时提升低概率正确token的学习机会。Entropy-Aware Advantage则尝试让高熵token获得更大的advantage。不过,高熵只代表当前状态存在较大的变化空间,并不意味着更新一定会推动熵上升。因此,真正需要控制的并不是熵越高越好,而是每一次参数更新带来的熵变化是否稳定。STEER:为剧烈熵变化设置限速器
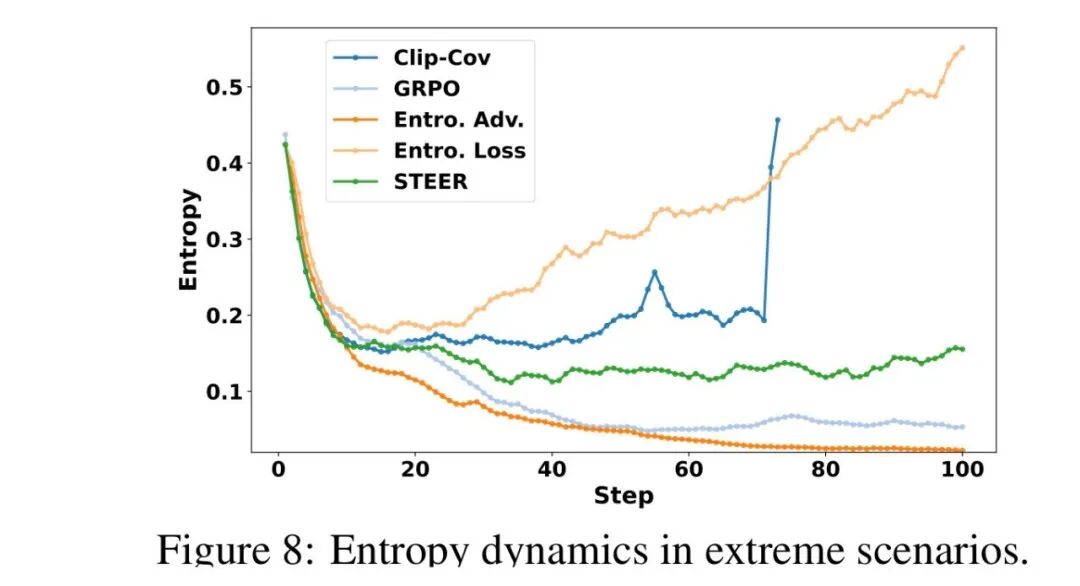
基于上述发现,作者提出STEER,全称为Stabilizing Token-level Entropy-changE via Reweighting。它的思路非常直接:先估计每个token在当前更新中可能带来的熵变化,再根据变化幅度重新分配训练权重。当某个token可能引起过大的熵变化时,STEER会适当降低它的权重;当熵变化处于合理范围时,则基本保留原有学习信号。因此,STEER并不是简单地给模型增加entropy bonus,也不是要求模型始终保持高熵。它更像一个token-level的训练限速器,让模型在强化正确推理路径的同时,继续为新的有效路径保留空间。数学与代码任务均获得提升
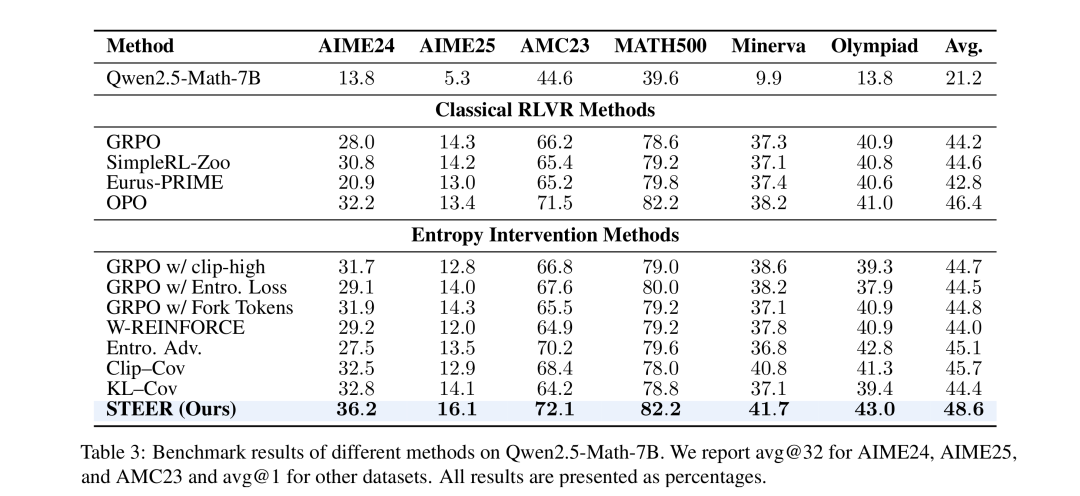
在数学推理模型强化学习任务中,Qwen2.5-Math-7B使用STEER后,六个基准的平均成绩达到48.6,高于标准GRPO的44.2。
在代码大模型强化学习任务中,Qwen2.5-Coder-14B的代码编辑性能由42.6提升至45.1,LiveCodeBench v5成绩由29.3提升至31.8。
论文还在Qwen、Llama、Mistral等不同模型家族,以及GRPO、RLOO、OPO等多种算法上进行了验证,均获得了相对稳定的收益。这说明STEER并不依赖某一个模型或单一测试集,而是为可验证奖励强化学习提供了一种具有通用性的熵控制机制。这项工作的核心价值,在于把模型是否还在探索,从一条整体训练曲线,拆解成每个token的具体变化。大模型推理能力提升不仅需要强化已经验证有效的答案,也需要在训练过程中保留足够丰富的推理可能性。当模型既能巩固已有路径,又能继续发现新的有效分支,RLVR才能释放更大的长期训练价值。