




在当今的AI圈,大模型秀肌肉似乎成了一种常态。
我们已经习惯了看到几百亿、上千亿参数的庞然大物在各大榜单上刷榜。但是,如果你听到一个仅有3B参数的小模型,在关键的视觉感知任务上,直接硬刚并超越了巨头级的 Gemini 3.1 Pro,你会不会觉得不可思议?
这不仅不是天方夜谭,而是正在发生的现实。
在 Om AI 联汇最新发布的 VLX 端侧流式多模态模型系列中,VLX-Seek强势登场。
它不仅补齐了传统视觉语言模型在精准定位上的短板,更向我们证明了一条全新的高效技术路径:在很多时候,AI 并不需要无脑堆参数,找对方法,小个子也能爆发出惊人的能量。
为什么强大的VLM,总是看得懂却指不准?
我们先来聊聊行业痛点。
在的 VLM 已经很聪明了,你给它看一张照片,它能洋洋洒洒写出一篇小作文:画面里有几个人正在喝咖啡,桌子上放着杯子和书本。
但是,如果你把任务交给机器人,情况就变了。当你发出指令:“去跟着左边那个穿红衣服的人”,或者“把桌子上最右边的那个蓝色杯子递给我”,传统的 VLM 往往会瞬间宕机。
为什么?因为描述一张图和精确定位图里的目标,完全是两码事。
在传统的技术路径中,为了提升视觉语言模型目标检测能力,开发者通常会让语言模型直接生成坐标。
这种方式看似简单粗暴,实则非常脆弱。你可以把语言模型想象成一个文科生,它擅长咬文嚼字,但你非要让它稳定输出精确的几何数值,这就有点强人所难了。
一旦遇到多目标场景,比如画面里有十几个物体,模型就需要输出几十个坐标 token。
在这个冗长的输出过程中,只要归一化范围、标点格式哪怕错了一个字符,整个框就可能彻底偏离目标,甚至直接导致系统无法解析。
更致命的是,这种方式很容易引发幻觉。比如画面里根本没有“穿蓝色制服的工作人员”,强行生成坐标的模型可能就会胡乱指一个相似的区域。
而对于具身智能来说,我们需要的是有效解决VLM幻觉式检测问题,让它在没有目标时老老实实回答没有。
此外,长坐标序列会严重拖慢推理速度。在云端等一等也就罢了,但在毫秒必争的端侧设备上,这种延迟是不可接受的。
把做算术题变成做选择题
既然直接生成坐标这条路走得磕磕绊绊,VLX-Seek 的切入点非常巧妙,VLX-Seek 引入了一种全新的目标级感知方式:区域Token替代坐标生成。
简单来说,它不再逼着模型去算坐标,而是先通过 OPN把画面里所有可能是候选目标的区域框出来。然后,给这些候选区域贴上标签,变成可以被语言模型读取的Region Token。
比如当用户提问“穿红衣服的人在哪里”时,模型不需要去想坐标是多少,它只需要在这些候选区域里做语言条件检索,判断哪个区域最符合描述,然后直接输出对应的区域编号。
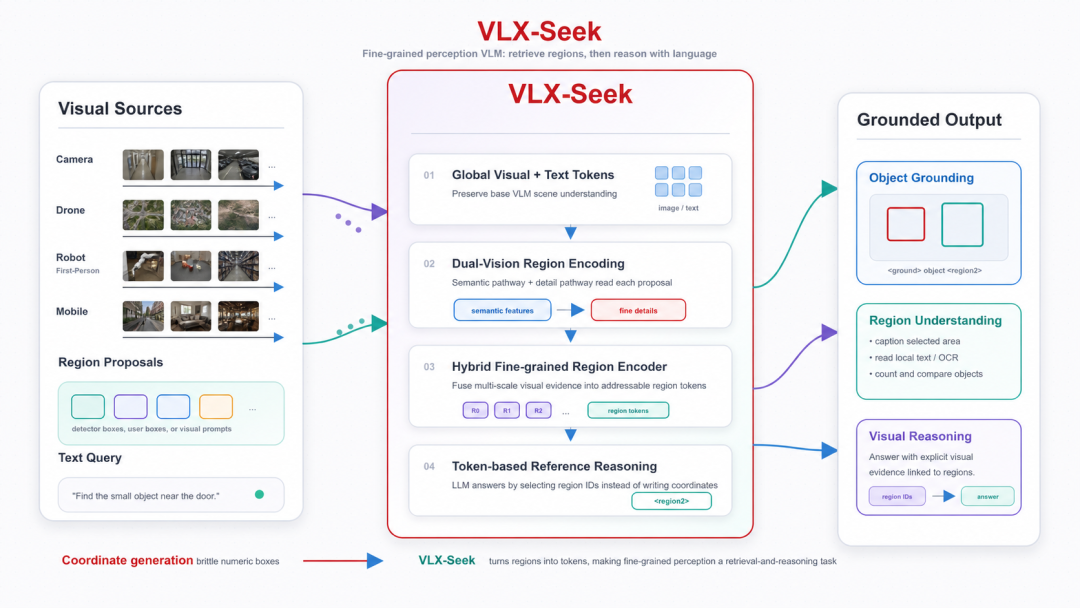
这就好比把一道极具挑战的填空算术题,变成了一道语言模型最擅长的阅读理解选择题。这不仅大幅降低了解码开销,更让模型在处理自然语言指代目标定位任务时,表现得稳如泰山。
双眼看世界
当然,光把区域圈出来还不够,模型还得知道这个区域里到底是什么。这时候,VLX-Seek 独创的 HFRE就派上用场了。
单一的视觉编码器很难做到十全十美。通用大模型的编码器懂语义,知道这像一辆车,但对边缘、小目标这些细节不敏感;而专业的检测编码器能看清纹理,却很难和语言模型的高级思维同频。
VLX-Seek 聪明地采用了双视觉路径:
主视觉编码器:保留高层语义,让模型具备全局理解力。
辅助视觉编码器:提供高分辨率的局部细节,让模型看清边界和微小差异。
配合 SimpleFP 模块补足多尺度表达,无论目标是占据半个画面的大个子,还是角落里的一个小杯子,模型都能精准捕捉。这就意味着,在复杂的机器人视觉多目标识别任务中,VLX-Seek 能够精准区分每一个细微的实例,不再脸盲。
3B小模型的越级挑战
光说不练假把式,我们来看看硬核的数据表现。在近期的3B参数VLM模型性能对比中,VLX-Seek-3B 交出了一份令人惊艳的答卷。
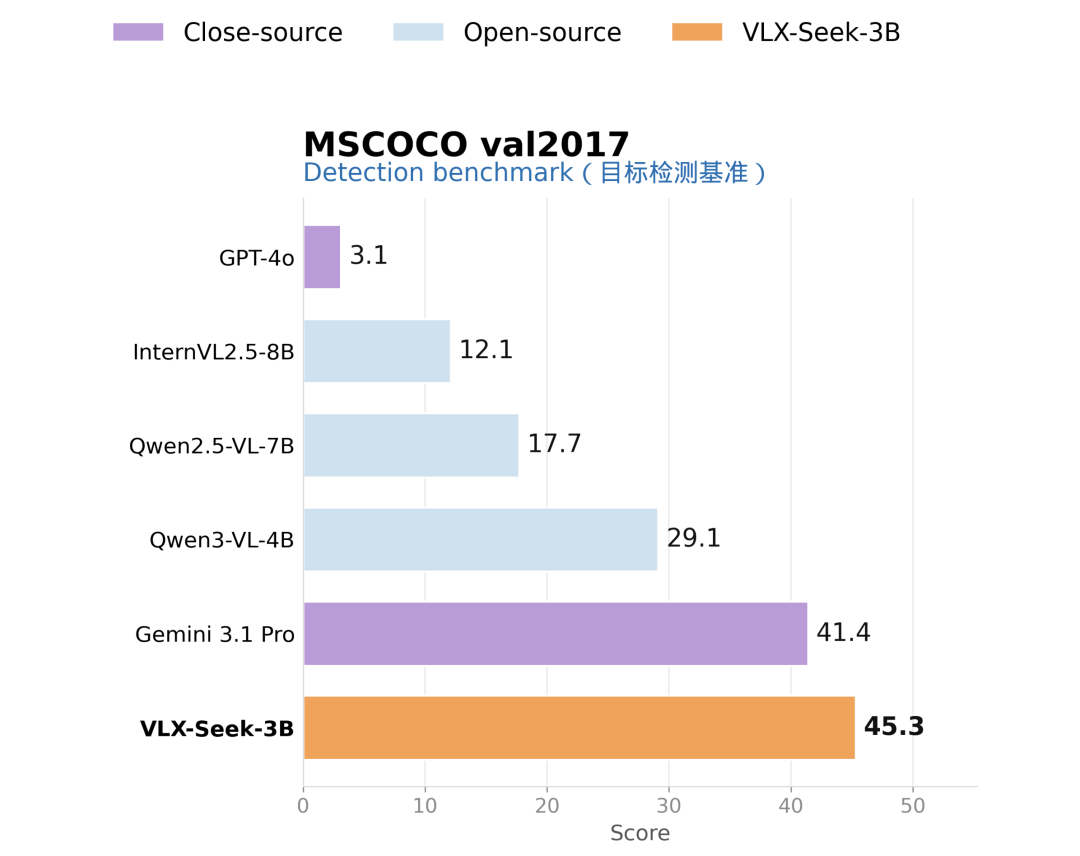
MSCOCO val2017:
VLX-Seek-3B 拿下了45.3的 mAP,直接超越了行业标杆 Gemini 3.1 Pro 的41.4,也将 Qwen2.5-VL-7B 甩在身后。在这个量级实现小参数模型超越Gemini,含金量极高。
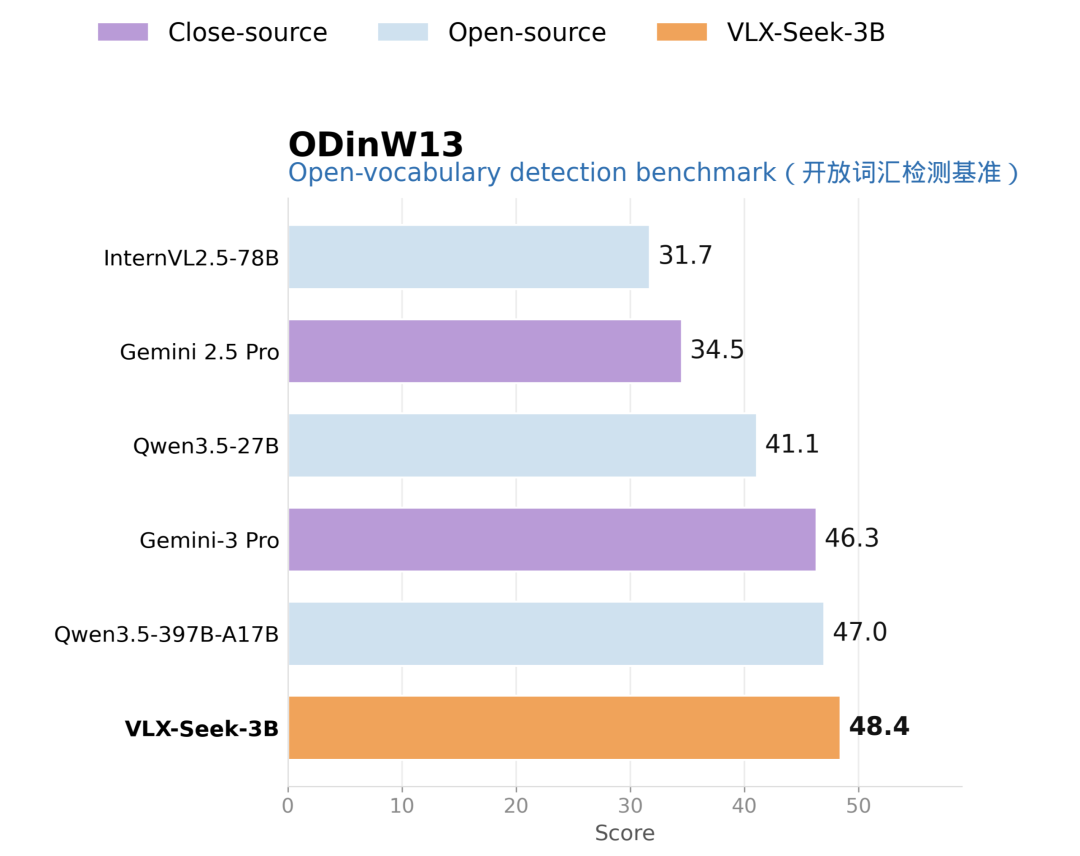
开放词汇检测:
面对未知的开放类别和复杂的语言标签,在严苛的开放词汇检测模型评估标准 ODinW13 中,VLX-Seek 达到了48.4,再次超越了体积庞大得多的 Qwen3.5-397B-A17B 和 Gemini 3 Pro。
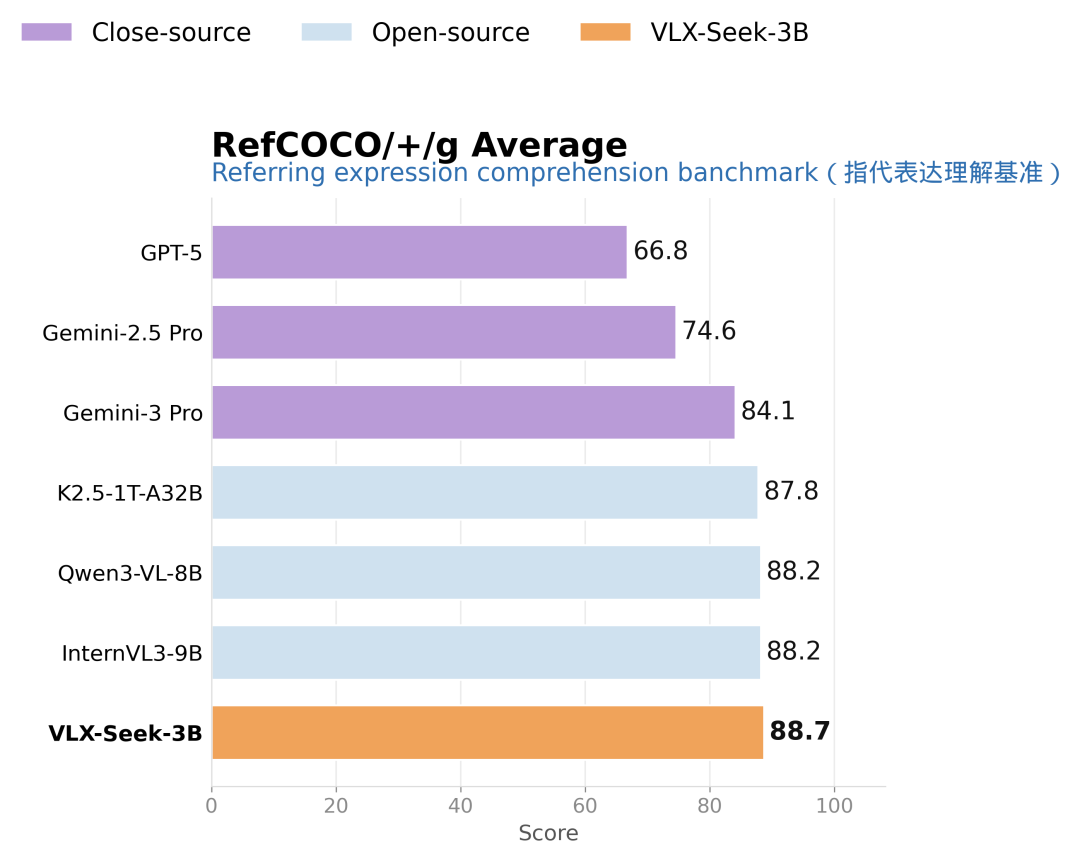
RefCOCO 系列:
面对靠近桌子的杯子这种复杂的自然语言指令,它取得了88.7的平均分,位居前列。
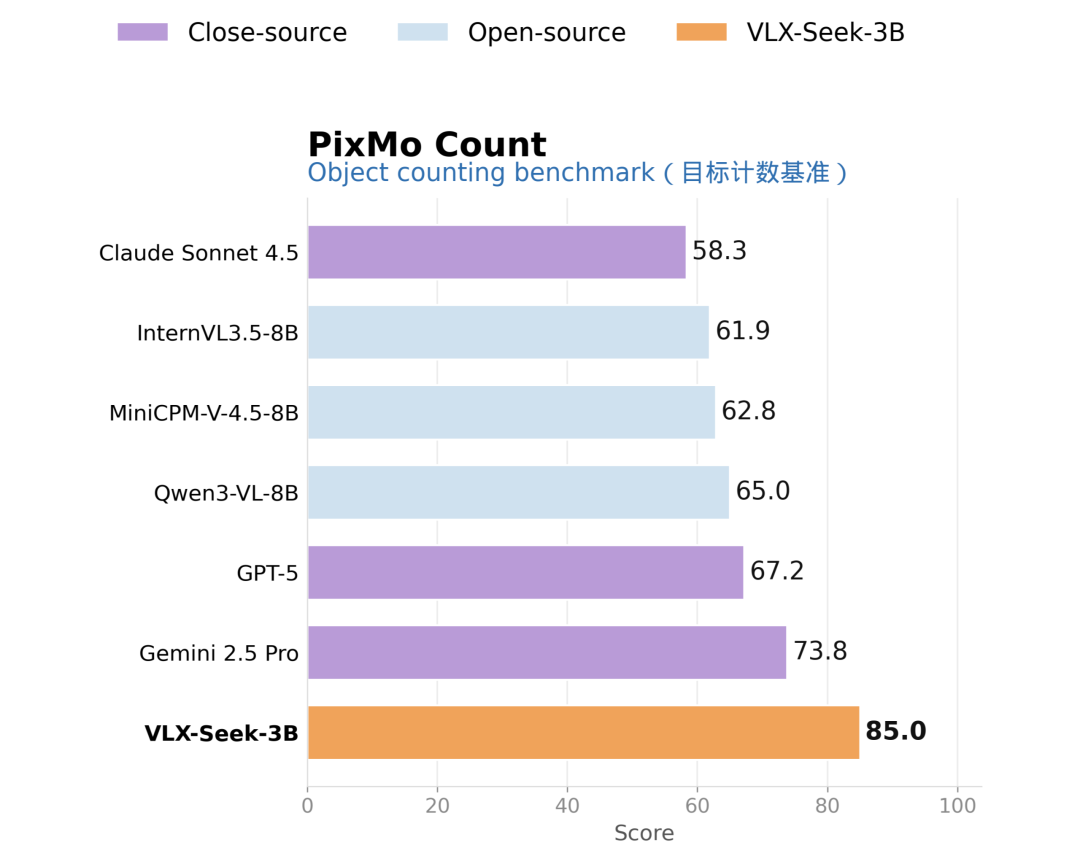
PixMo Count:
这是极其考验模型细节感知能力的任务。依靠先检测后聚合的区域机制,VLX-Seek-3B 拿到了85.0的高分,大幅领先 Gemini 2.5 Pro 的73.8。
这些数据证明了一件事:在精细化感知这条赛道上,架构的先进性与任务对齐的精准度,远比单纯堆砌参数量更重要。
具身智能的强力引擎
为什么我们要如此执着于把模型做小、把定位做准?因为这关乎着AI大规模落地的未来。
在丰富的端侧多模态大模型应用场景中,比如无人机巡检、智能安防摄像头、家庭服务机器人,设备往往没有条件连接庞大的云端算力。它们需要的是低延迟、低功耗、高稳定性的离线决策能力。
VLX-Seek 仅有 3B 的规模,配合极低的解码开销,大幅降低了部署门槛。它为优秀的具身智能端侧视觉部署方案提供了一个绝佳的范本:机器人要执行跟随、抓取或避障动作,必须先有稳定的空间锚点。
不再受限于固定的类别框,不再被长序列输出拖垮,VLX-Seek 让区域直接进入模型内部参与推理,真正打通了从画面理解到目标锁定的关键一步。
科技的进步,往往不在于造出多庞大的巨兽,而在于让智慧变得更加灵动和可用。
Om AI 联汇的 VLX-Seek,用极具创新的区域 Token 机制,证明了小模型在垂直专业领域同样可以拥有顶级的视觉感知力。端侧具身智能的爆发前夜,我们非常乐见这样务实且强大的技术破局者。
你认为�� VLX-Seek 这样主打小而美、快而准的端侧视觉模型,未来最先会在哪个行业迎来爆发式应用?欢迎在评论区留下你的硬核观点,我们一起探讨!