




国产算力生态的一道关键难题,终于有了 AI 的解法。
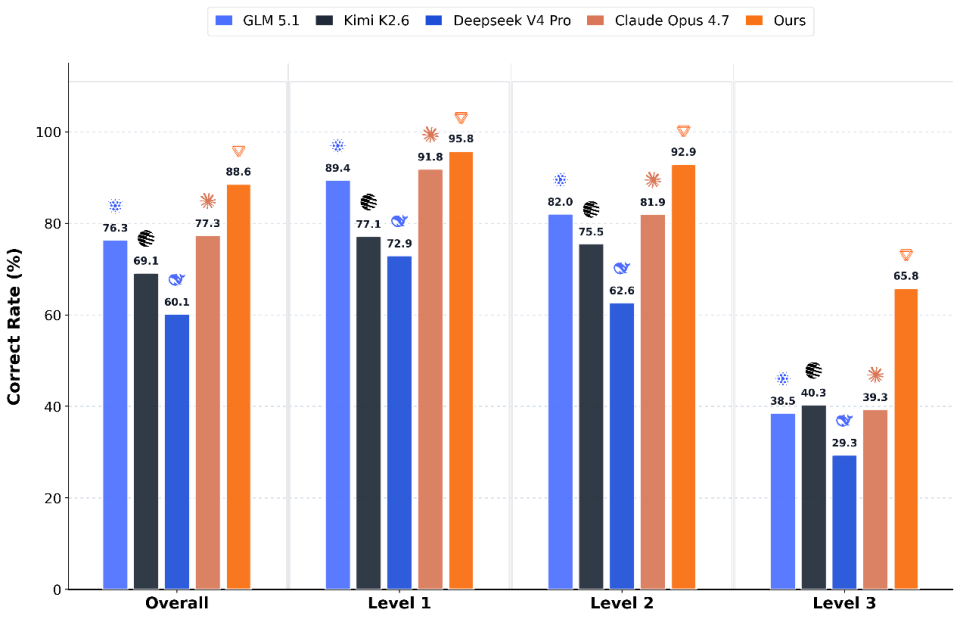
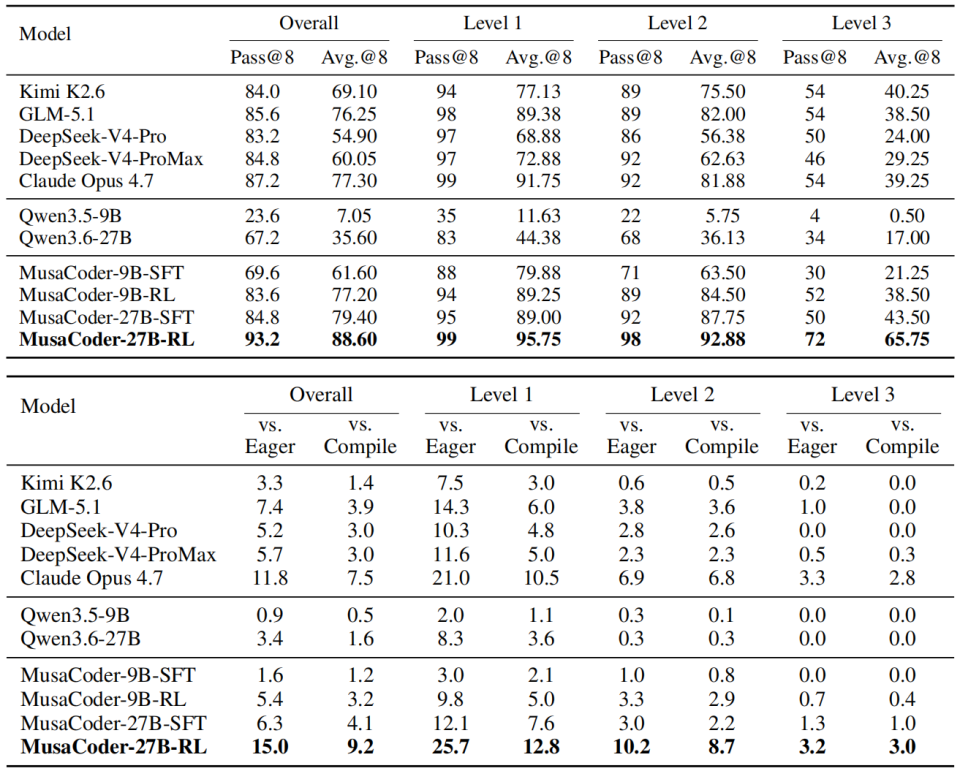
上周,一个消息在 AI 圈里刷了屏,在被称为「AI 生成 GPU 内核最硬核考试」的 KernelBench 基准测试上,摩尔线程的 MusaCoder-27B-RL,拿下了全球第一。
在 MooreEval 执行式验证协议的加持下,MusaCoder 一举超越了 Claude Opus、GLM-5.1、Kimi K2.6 等一众国内外先进大模型。
更令人关注的是:MusaCoder 仅有 270 亿参数,而被它击败的对手,参数量动辄在几千亿到上万亿级别。
这是「小模型」对「大模型」的一次漂亮逆袭。
KernelBench:凭什么是最硬核的 AI考试?
这项由斯坦福大学和普林斯顿大学联合打造的大模型 GPU 内核代码生成能力基准,之所以被业界视为金标准,在于它的评估方式极度严苛。
它包含超过 250 个 PyTorch 机器学习任务,按复杂度和粒度划分为四个递进难度级别,从 Level 1 的卷积、矩阵乘法、归一化等核心基础算子,到 Level 4 的 Hugging Face 生产级模型优化任务。
每一关都在挑战 AI 对并行计算、线程组织、内存访问模式和底层硬件执行特性的真正理解。
关键在于:这里不是能做对就行。
KernelBench 要求模型自动生成的 CUDA 内核代码不仅要语法正确、能通过编译,还必须带来真实的性能加速,加速比必须超过设定阈值。光正确还不够,得真正有用。
DeepSeek R1 刚推出时,全部任务通过率只有 30%,而且这只是代码能跑的比例,还不是能带来性能提升的比例。而 MusaCoder 目前的通过率已做到 88.6%,部分生成代码的性能比基准线高出至少 1.1 倍。
以小博大的秘诀:三把技术钥匙
GPU 内核代码���动生成对 AI 是极艰难的挑战。它不像写普通代码,需要对并行计算模型、线程层次、共享内存、索引映射等底层概念有精确理解,差一个索引就可能造成性能骤降甚至程序崩溃。
MusaCoder 能做到这一点,靠的是三把技术钥匙。
1.MooreEval 执行式验证协议
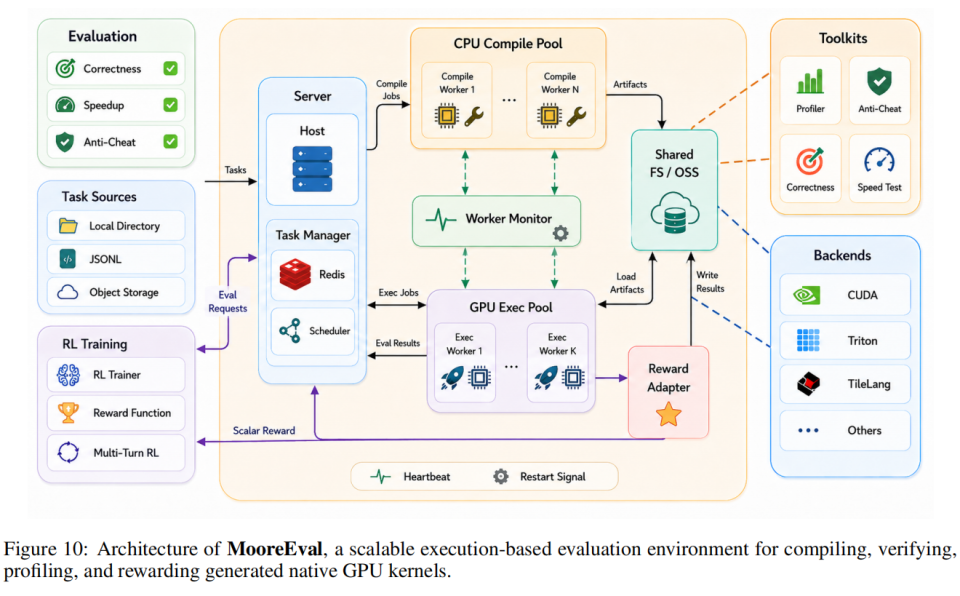
这是一套专为 GPU 底层算子生成设计的分阶段自动化验证系统。它不像传统方法只看代码文本相似度,而是真正把生成的内核代码拿去编译、执行、做性能测试,还自带反作弊检测。通过一关才能进入下一关,层层递进。
更精妙的是它是一个分布式异步流水线, CPU 密集型的编译工作和 GPU 密集型的执行工作被分配给不同类型的 Worker,各自独立伸缩,GPU 不必干等编译完成。
2.三阶段渐进式数据合成
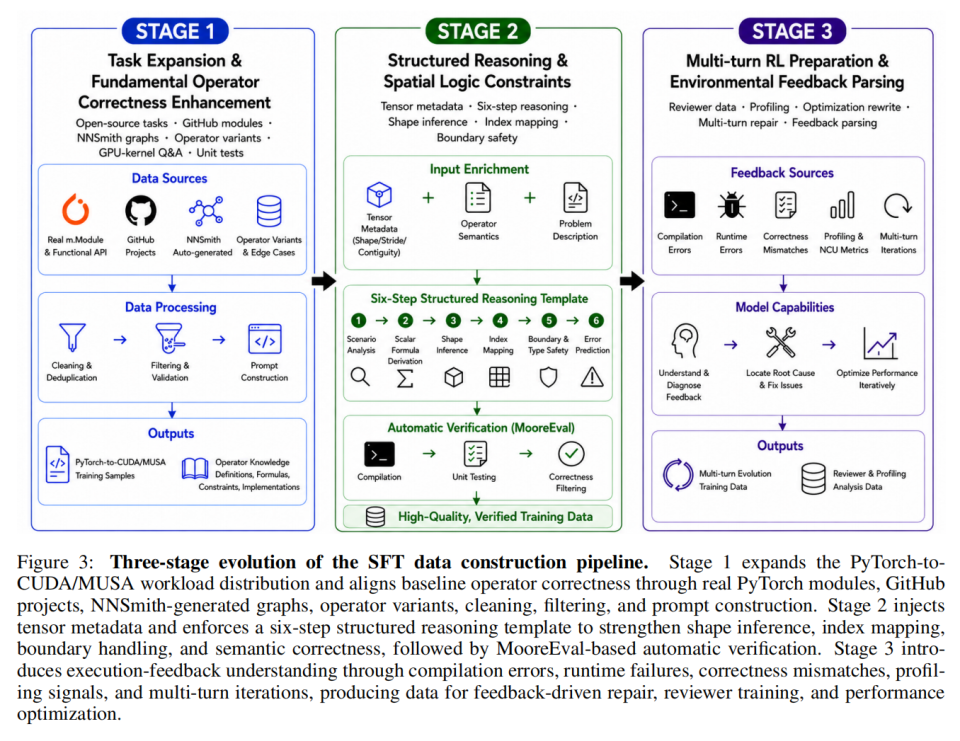
MusaCoder 的训练数据并非简单爬取,而是通过一套精心设计的三阶段管道系统性构建。
先从 GitHub 真实代码和自动生成工具构建基础任务集,注入 GPU 编程基础知识;再通过结构化推理和 Shape 信息注入增强模型对张量形状和内存布局的理解;最后是多轮环境反馈交互,让模型学会根据编译报错和执行结果自我修复和优化——为后续的强化学习训练铺路。
3.三项强化学习稳定机制
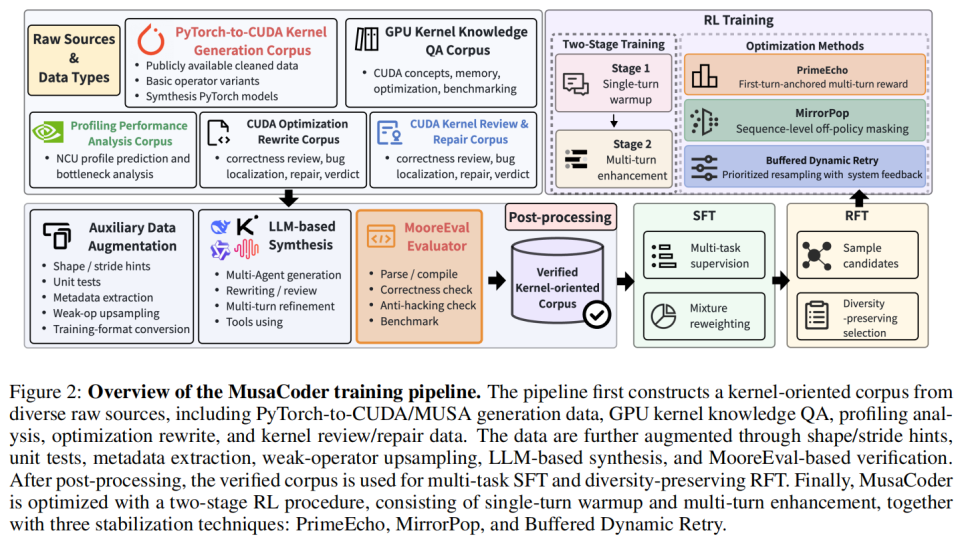
GPU 内核生成这类高难度任务,正样本极为稀缺,训练中容易出现奖励作弊和不稳定。MusaCoder 用三项机制精准破解了这个难题:
PrimeEcho:首轮锚定多轮奖励机制,确保 AI 优先提升一次写对的能力,而非靠反复修改蒙混过关。
MirrorPop:智能过滤器,精准剔除可能导致训练不稳定的高风险数据。
Buffered Dynamic Retry:专门挽救完全失败的困难样本,从废品中回收学习信号,让模型学会修复自己的错误。
国产闭环:从芯片到模型的完整验证
MusaCoder 最大的意义,不止于一个模型的性能。
它的整个训练流程,从监督微调到强化学习,全部运行在摩尔线程自有的夸娥智算集群上。
底层是 MTT S5000 国产全功能 GPU,上层是自研的 MUSA 统一系统架构软件栈。这是业内首个在国产 GPU 算力底座上完成全链路训练与验证的开源代码大模型。
AI 自动生成高性能 CUDA 内核,是破解算力瓶颈的关键方向之一。让 AI 掌握这项能力,不仅能推动生成式代码技术的前沿进展,更将为降低算力成本、提升能效提供直接可用的工具。
MusaCoder 打破了国产 AI 算力只能跑推理的刻板印象。
能够稳定承载代码大模型的后训练全周期,意味着国产硬件已经从可用走到了好用的阶段。从芯片制造到软件栈,从训练平台到评测体系,再到开源模型生态,国产力量已经能够在这个领域形成完整闭环。
对于广大开发者来说,一个能直接从 PyTorch 自动生成高性能 MUSA/CUDA 内核的基础模型已经开源。用 AI 编写底层 GPU 内核代码的时代,真的来了。
或许用不了多久,为国产 GPU 底层算子做加速优化,会变得像今天用 AI 写代码一样简单。