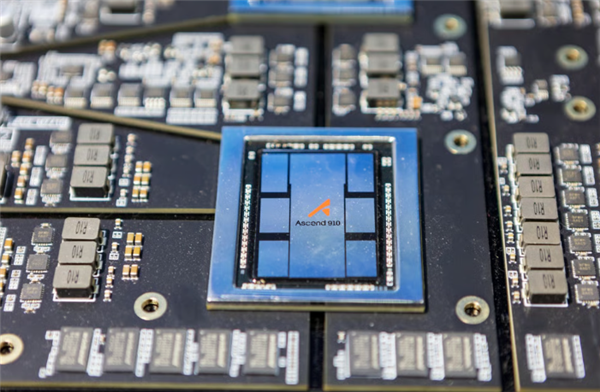
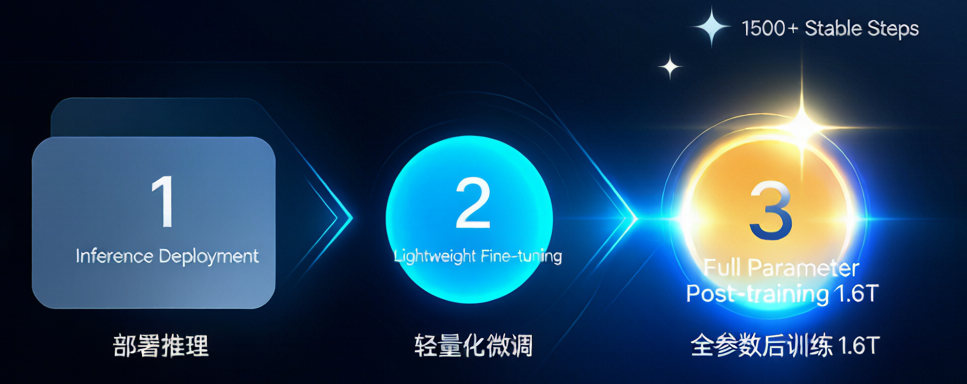
深圳河套学院AI训练平台项目团队,联合哈尔滨工业大学、深圳市大数据研究院以及华为相关团队,依托昇腾910C国产AI算力集群,成功完成了DeepSeek-V4-Pro这一1.6万亿参数大模型的全参数后训练,并实现了连续1500步以上的稳定运行。此前业界普遍认为万亿级大模型训练必须依赖英伟达A100/H100级算力。国产AI芯片大模型训练到底行不行?这次深圳团队直接给出了掷地有声的答案:不仅能行,还能跑得很稳。1500步,每一步都是硬功夫
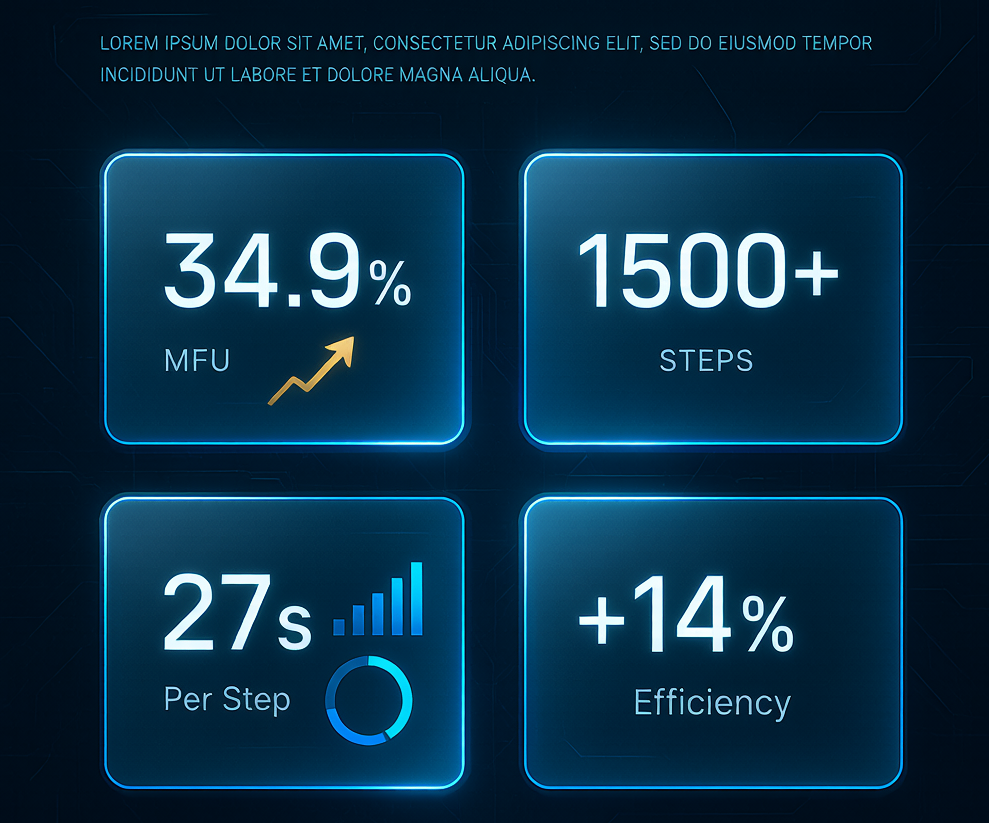
在大模型训练中,步数是一个看似朴素但极其关键的指标。它就像马拉松选手的每一步落地,一次中断就可能让前面的积累大打折扣。这次训练全程1500多步,没有出现一次Loss失控,没有产生一个NaN异常值,模型算力利用率从初始约30%稳步提升至34.9%,单步训练耗时稳定在27秒。万亿参数大模型训练需要多少算力,远不止芯片峰值性能的加减乘除。真正的挑战是:1000颗芯片同时工作,数据如何在芯片间高效流转?梯度如何精确同步?一旦某张卡掉队,整个集群就受影响。这考验的是国产算力集群分布式训练的系统工程:芯片互联通信、显存管理、分布式训练框架调度,一整条链路都不能有短板。一是构建了权重、梯度、激活、优化器状态的分布式并行承载方案,实现数据并行、张量并行、流水并行和专家并行的四维协同;
二是针对MoE架构优化了专家路由和负载均衡机制;
三是搭建了全指标可视化长稳监控系统,确保每一步都透明可控。
做难而正确的事
部分参数微调只更新模型最后几层或插入少量适配器模块,省算力但天花板低。全参数后训练让全部1.6万亿个参数都参与更新,模型在数学推理、代码生成、指令遵循等任务上实现从能用到好用的质变。代价也很直接:对显存、通信和系统稳定性的要求指数级上升。这也解释了为什么此前几乎没有第三方团队在国产芯片上完成DeepSeek-V4-Pro全参数后训练。这次训练同步打通了DeepSeek-V4-Flash的全参数续训练与SFT完整链路,数学建模任务ORGEval WL提升超5个百分点。这不是一次性演示,而是可复现、可工程化交付的工业级方案。从能用到好用,国产算力正在闭环
DeepSeek-V4-Pro采用MoE架构,训练时所有专家模块同时学习、相互通信,专家间数据交换量是普通稠密模型的数十倍,对芯片互联带宽压力极大。昇腾910C集群能在这种高负载下稳定运行,说明国产芯片通信互联方案已走过从0到1的验证。放在更大的背景下,国产芯片替代英伟达A100的努力,本质上不是为了证明谁跑分更高,而是要确保中国AI产业有一条独立可控的算力供给线。昇腾910C千卡集群的表现说明了一个道理:单芯片性能差距可以通过系统级优化和规模化部署来弥补,这条路走得通。在美国持续收紧芯片出口管制的环境下,这次突破为中国AI产业实现国产AI算力去风险化提供了最重要的信心锚点。它不是终点,而是一个清晰的起点:国产AI基础设施正从推理部署和轻量化微调,迈入超大模型全参数后训练的新阶段。新一轮AI基建浪潮中的确定性机会
当AI算力的国产化路径逐渐清晰,整条产业链的上游,通信资源与算力调度就变成了新的关键变量。万亿参数大模型分布式训练,本质上是算力、数据和通信三者高度耦合的系统工程。AI大模型训练MFU利用率每提升一个百分点,背后都需要更精细的通信调度、更稳定的Token分发链路来支撑。无论底层芯片是谁家的,上层应用的爆发都绕不开一个基础需求:高质量的通信资源通道。硕软深耕通信行业二十年,是国内少数具备电信运营商级别Token分发与管理能力的专业通信资源服务商。企业依托成熟的全球通信资源网络与多年行业运营经验,专注为各类合作方提供定制化Token解决方案,同时输出全域渠道运营赋能服务。在AI算力集群从能用走向好用的过程中,稳定、高效、可弹性扩展的通信底座始终是不可或缺的一环。硕软正是这个环节里兼具资源实力、技术能力与方案定制能力的通信生态服务商。